网站 AI 搜索体检清单:13 项检查与官方依据
网站在 Google 上排名正常,ChatGPT、Perplexity 回答相关问题时却从不引用它,这时要先排除技术原因:AI 的爬虫可能根本进不来,进来了也可能读不到正文。这篇把需要检查的地方分成 4 层 13 项,每项标明有多少官方依据,其中 7 项用本站的免费工具在 linusseo.com 上做了实测。
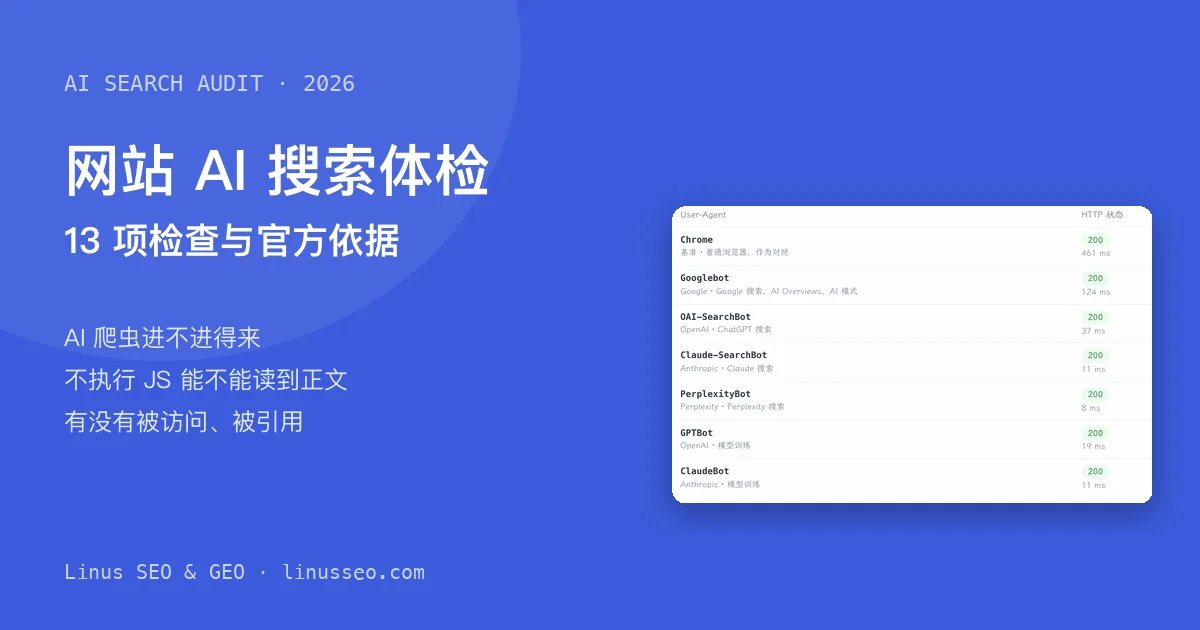
网站在 Google 上排名正常,ChatGPT、Perplexity 回答相关问题时却从不引用它,这时要先排除技术原因:AI 的爬虫可能根本进不来,进来了也可能读不到正文。这篇把需要检查的地方分成 4 层 13 项,每项标明有多少官方依据,其中 7 项用本站的免费工具在 linusseo.com 上做了实测。
每周一开会,老板问那几个核心词现在排第几。你在自己电脑上搜了一下,排第 5;同事在另一个城市搜,排第 9;Search Console 里写着平均排名 8.3;Semrush 里又是另一个数。这几个数字都没错,只是各自的算法和条件不一样。排名跟踪用固定的地区、设备和时间,每天记录同一批词的排名,让你能和上周、上个月比较。
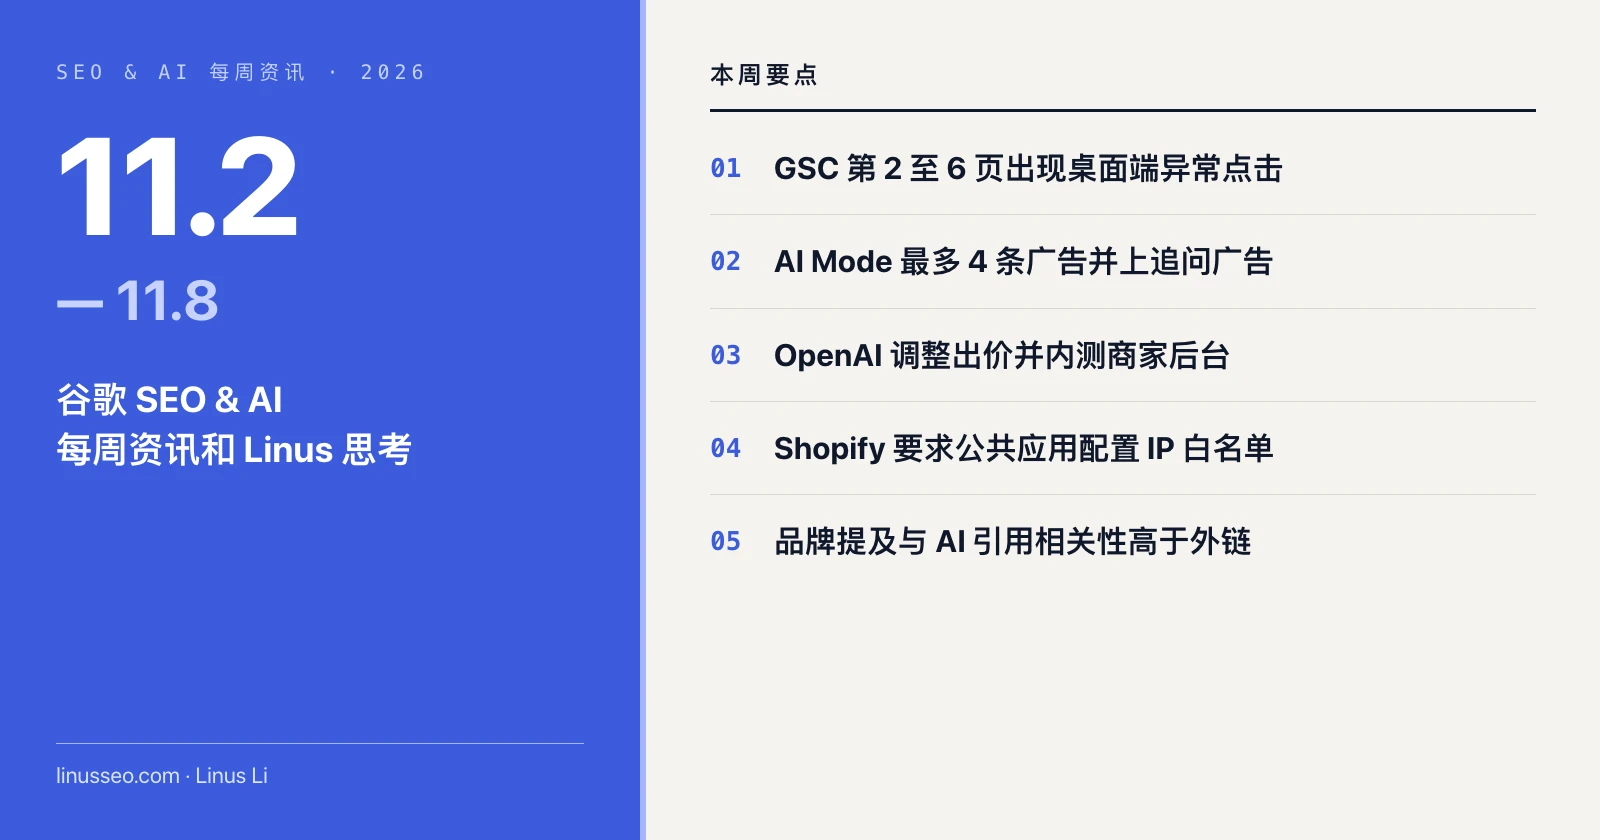
GSC 第 2 至 6 页出现桌面端异常点击;AI Mode 最多 4 条广告并上追问广告;Shopify 强制公共应用配 IP 白名单;品牌提及与 AI 引用相关性最高。
可能你经常遇到这种场景:老板突然丢来一个竞品网址让你摸清对方的底细,或者你想做新类目却不知道挑什么词,结果一打开 Semrush,左边密密麻麻几十个模块,完全不知道该先点哪一个。
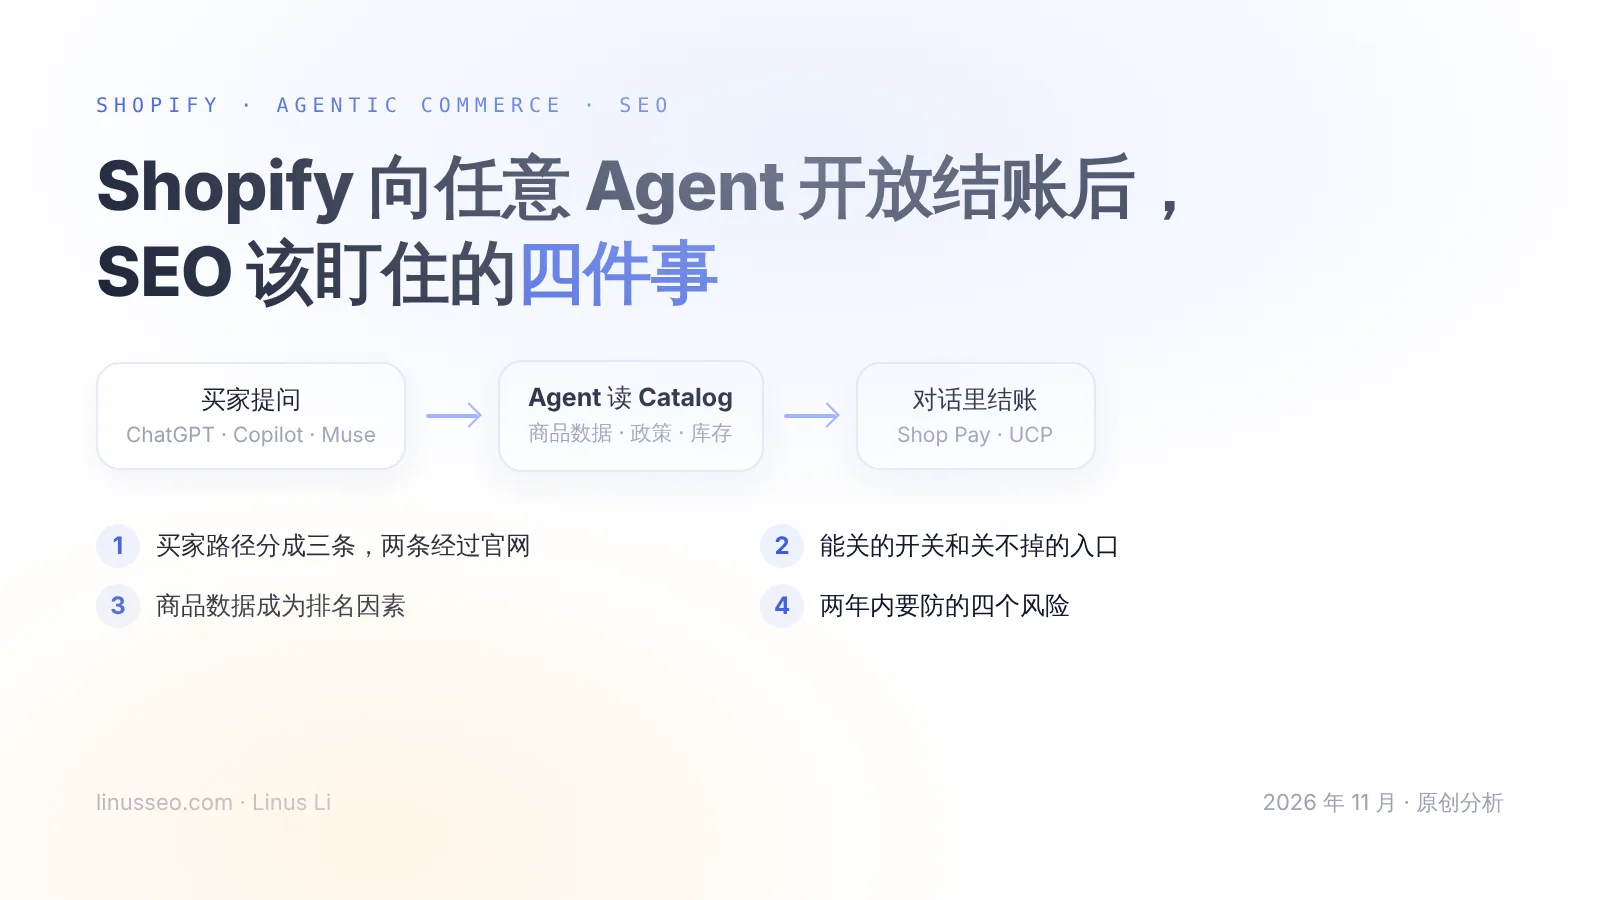
假设一个做户外装备的 Shopify 卖家问:Fall ‘26 之后,顾客在 ChatGPT、Copilot 或者 Meta 的 Muse 里问“200 美元以内防水的徒步鞋”,Agent 直接列出商品、加进购物车、用 Shop Pay 付款,整个过程没有打开过我的网站,那我做的 SEO 还有什么用。
我的结论是:SEO 的对象变了,从“让网页被搜索引擎排上去”变成“让商品数据被 Agent 读对、选中、买走”。网页没有失去作用,因为 Catalog 的数据来自网页,ChatGPT 的结账仍然回到官网,AI 回答里的第三方评价也来自网页。但是,排序的重心已经移到了商品数据、政策页和平台配置上,这三样过去很少进 SEO 的检查清单。
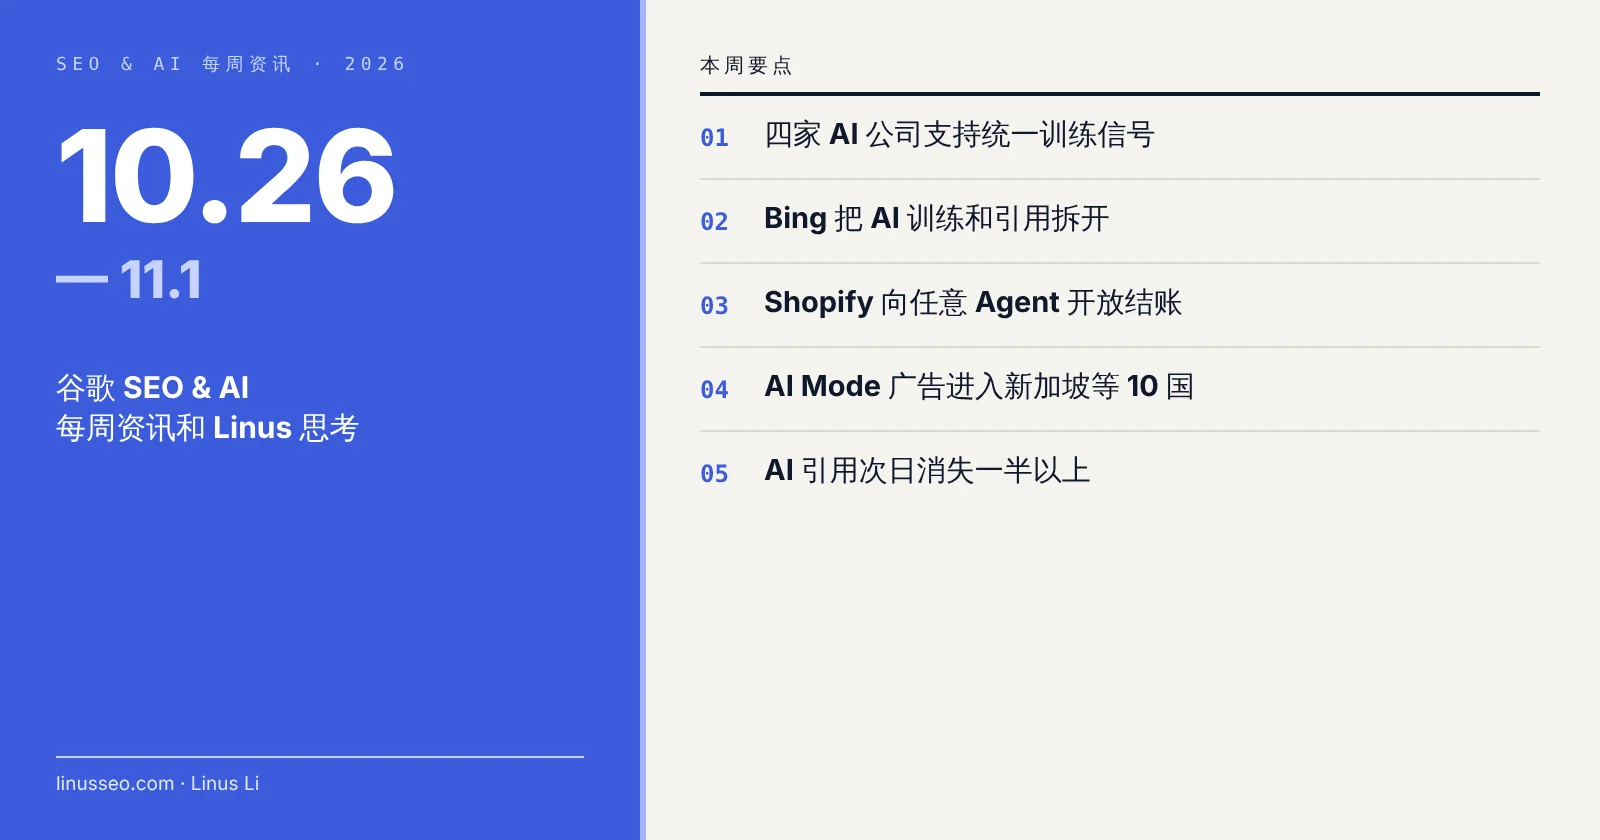
Google、OpenAI、微软支持统一的 AI 训练信号,Bing 把训练和引用拆开;Shopify 向任意 Agent 开放目录和结账,AI Mode 广告进入 10 国。
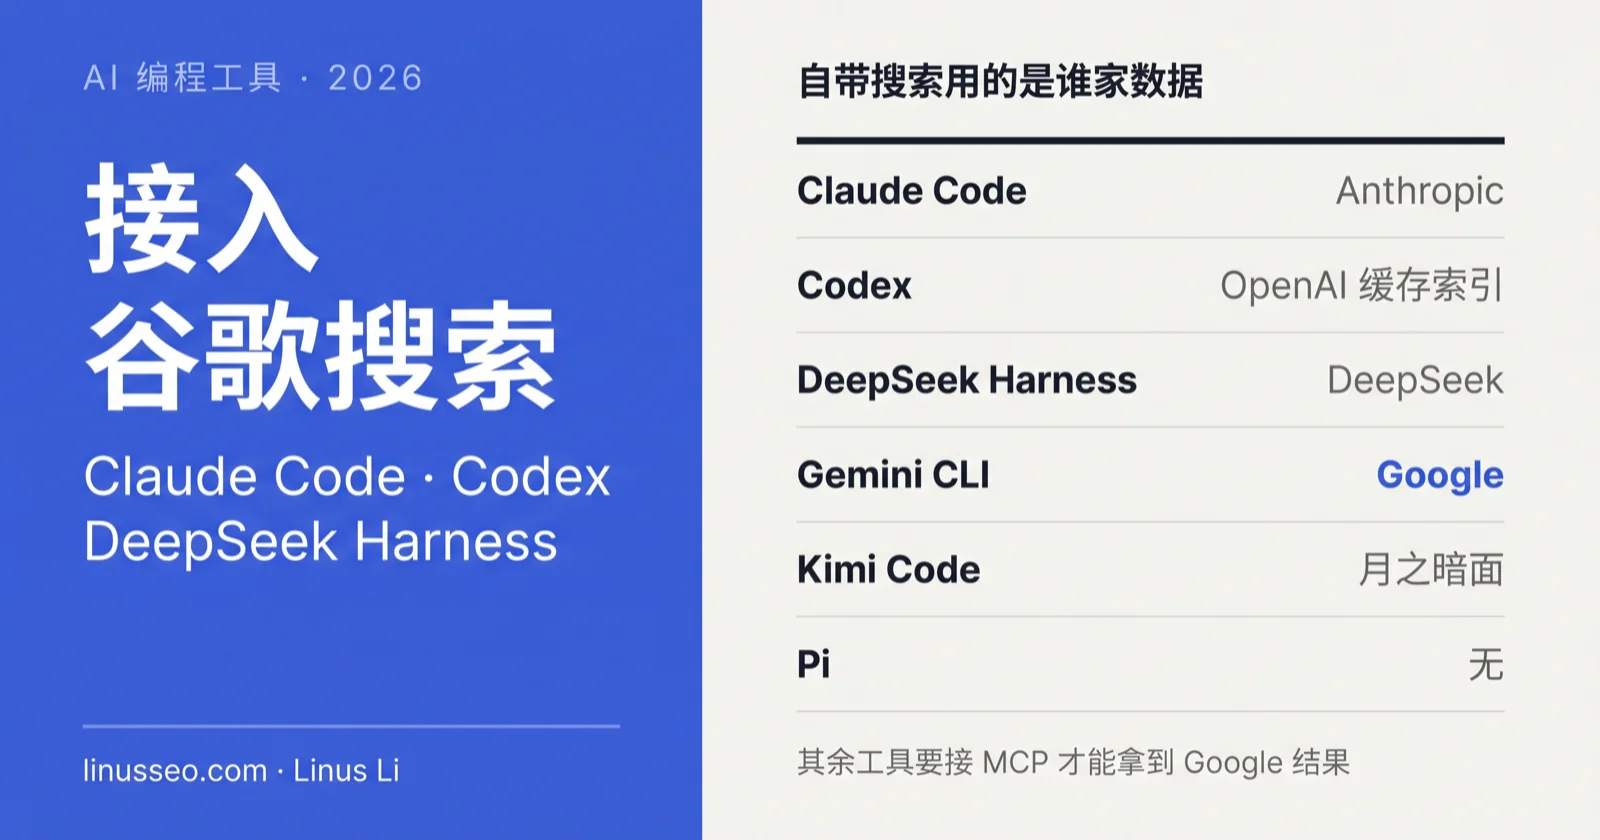
在 Claude Code 里让 AI“搜一下”,它确实会联网,但你拿到的通常不是 Google 的搜索结果。Codex、DeepSeek Harness、Kimi Code 也一样,它们各自用的是自家或合作方的搜索服务。
截至 2026 年 10 月 31 日,在常见的六个 AI 编程工具里,只有 Gemini CLI 自带的搜索用的是 Google 的数据。 其他工具想拿到 Google 的结果,要另外接 MCP 服务器或插件。最省事的做法是接 SerpApi 的官方 MCP,Claude Code 和 Codex 都只要一条命令。
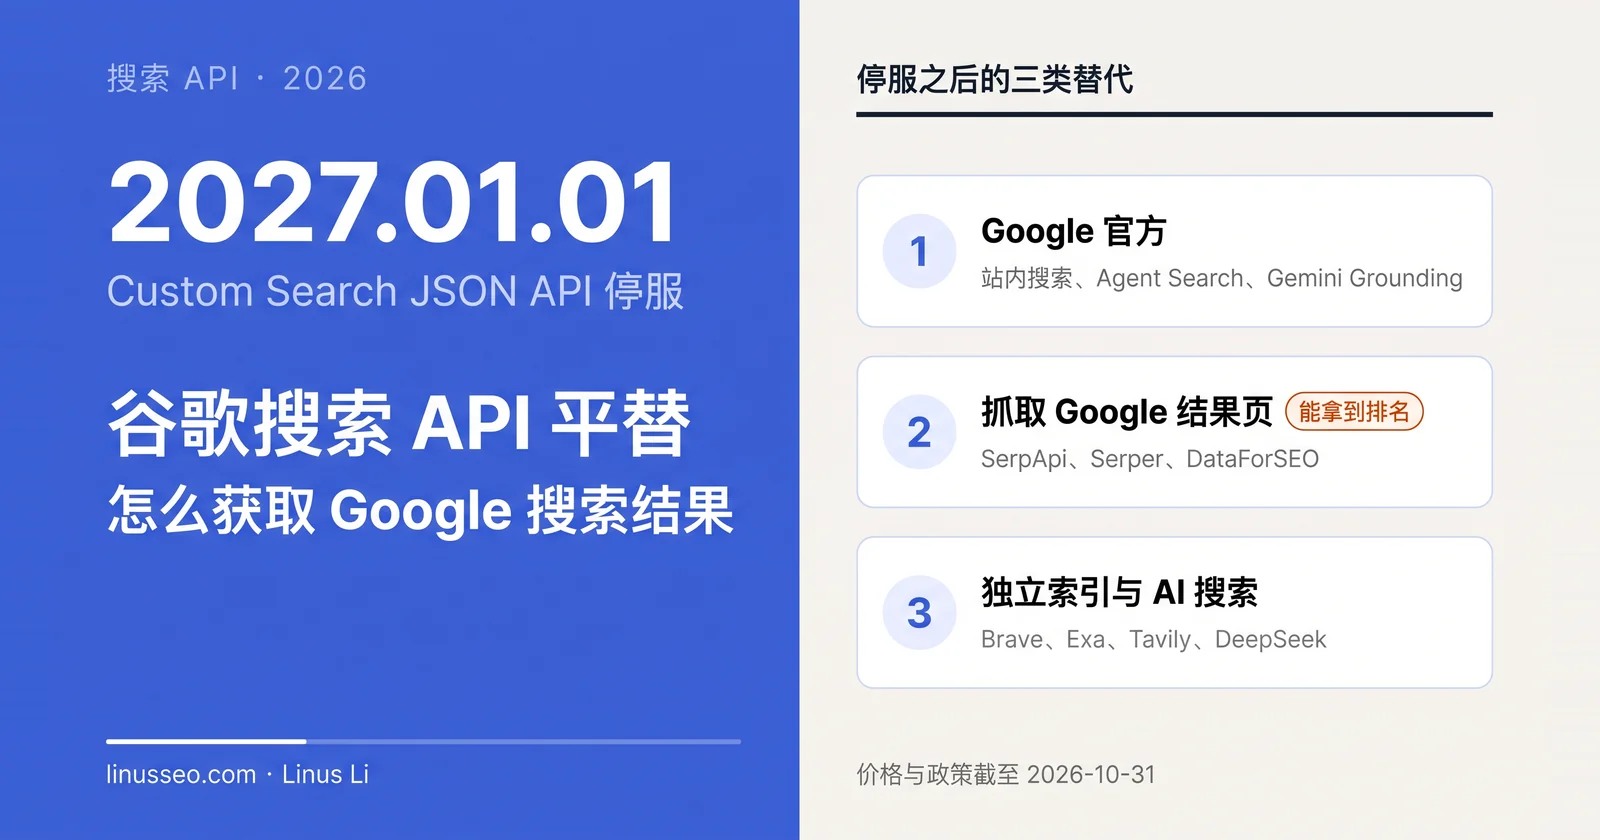
我在 NeverSec 时代写过一篇笔记,讲怎么用 Google 的 Custom Search JSON API 拿搜索结果。这个接口现在已经不接受新客户,并将在 2027 年 1 月 1 日停服。最近不少做 SEO 工具、数据抓取和 AI 应用的朋友在问同一个问题:停服以后,拿什么替代 Google 搜索?
截至 2026 年 10 月 31 日,Google 官方并没有一个能自助开通、直接返回全网搜索排名的 API。 很多团队直到旧接口停服才意识到:Custom Search JSON API 虽然叫 Custom Search,但当年被大量当成轻量级 SERP 接口使用。现在官方把路堵死,核心的分水岭只有一条:你到底是要 Google SERP 上的真实排名,还是只要模型能阅读的网页数据?
如果是前者(排名监控、SERP 特征追踪、竞品可见性分析),市面上任何官方 Grounding 接口都给不了,必须走抓取 Google 结果页的第三方通道;如果是后者(Agent 联网、知识库 RAG 检索),选用自建索引的搜索 API 往往更便宜、响应更快,也没有法务风险。
如果你只想尽快拿到搜索结果,直接看下一节的提示词。
Shopify 三款应用被劫持结账,PHP 曝出远程代码执行漏洞;Meta 条款推迟到 11 月 20 日,ChatGPT 广告扩到 89 国。
Google 推出 Universal Cart,Shopify 发布 Shop MCP;ChatGPT 丢失 UTM,排名工具收到假结果,Rank Math PRO 被植入后门。
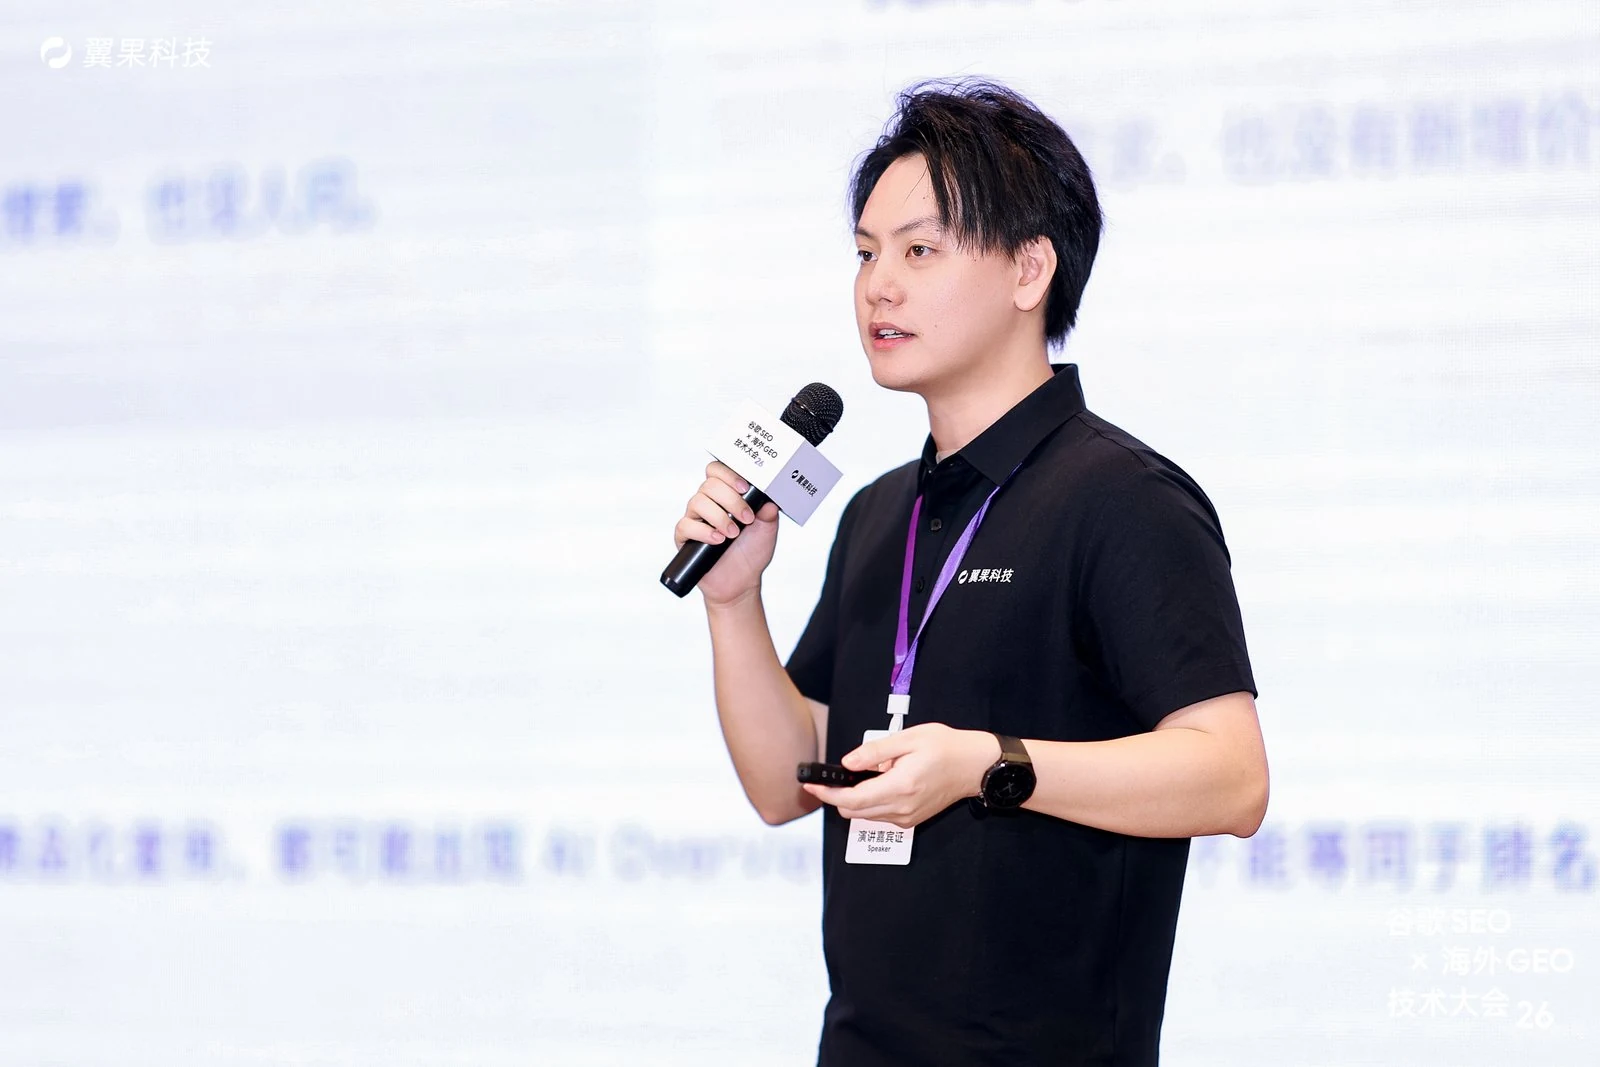
2026 年 8 月 12 日,我们在深圳办了 2026 谷歌 SEO × 海外 GEO 技术大会。我在会上讲了 45 分钟的《一份内容,两处收割:既上 Google 排名,又被 AI 引用》。当时有 300 多位独立站卖家和内容团队负责人在场,会后不少人来问同一个问题:现在用 AI 写一篇 2,000 字的博客只要几分钟,内容团队到底该把时间花在哪里,才能让同一套内容既排进 Google 前列,又能进入 ChatGPT、Perplexity 和 Google AI Overviews 的回答?
这篇文章把我在现场讲的那套 30 页课件完整摊开。我不打算给一份“AI 喜欢的文章格式”,而是按我们团队日常交付的顺序,把需求怎么拆、证据怎么补、几十个页面怎么对表、上线前怎么验收、不同岗位怎么拿同一套材料干活,原原本本讲清楚。
Google 9 月垃圾更新完成,Google 公开抓取与索引耗时,Merchant Center 和 Shopify 补齐 AI 购物数据,ChatGPT 上线 GPT-6。
Google 垃圾更新第二轮、AI Mode 监测与购物结账、Gemini 4、OpenAI Dots,以及 AI 搜索对零售和出版商的影响。
Google 9 月垃圾更新、多模态 Search Console、AI Mode 点击实验,以及 GPT-6 Sol/Luna 和 Claude Opus 5.5 的发布。
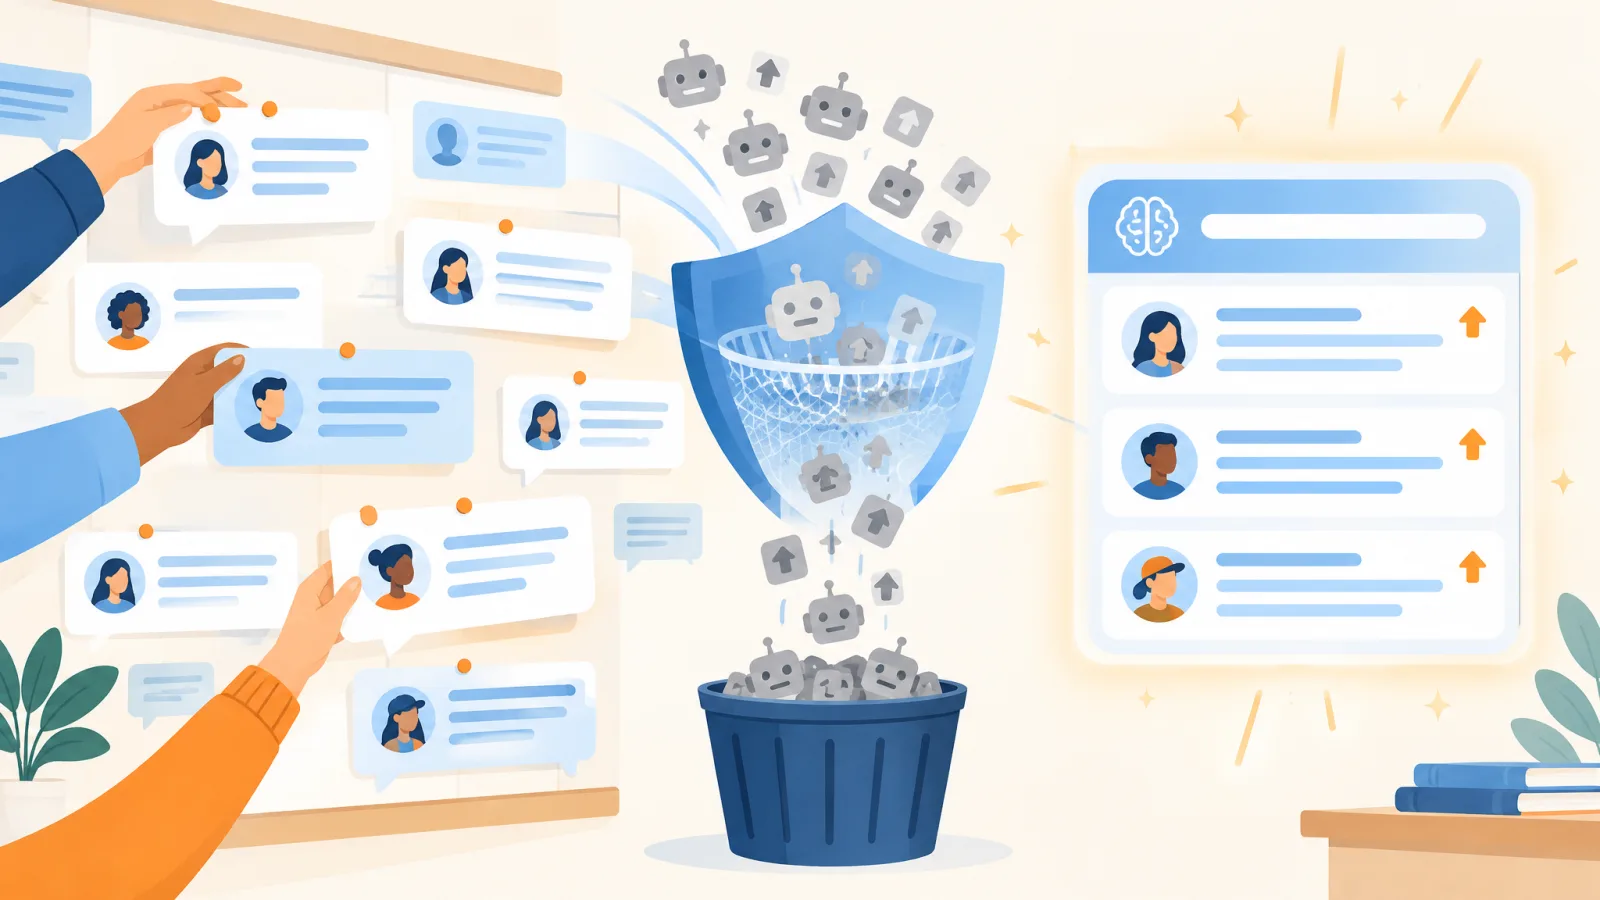
不少做出海和 GEO 的团队都在讨论同一件事:ChatGPT、Perplexity 和 Google 的 AI 回答经常引用 Reddit,那么在 Reddit 上多发帖、多评论、多顶帖,品牌是不是就能出现在 AI 的回答里。
Reddit 在 2026 年 7 月 6 日公布了一组反垃圾数据:每天在垃圾内容到达用户之前拦截约 2300 万次垃圾曝光(spam views),每天新抓到约 2.5 万条垃圾帖子和评论,过去三个月每天撤销近 200 万个虚假投票。所以,批量发帖、伪装用户讨论的做法在 Reddit 上越来越难成功。品牌应该先研究 Reddit 上已有的真实讨论,再用透明身份参与。