网站 AI 搜索体检清单:13 项检查与官方依据


网站在 Google 上排名正常,ChatGPT、Perplexity 回答相关问题时却从不引用它,这时要先排除技术原因:AI 的爬虫可能根本进不来,进来了也可能读不到正文。这篇把需要检查的地方分成 4 层 13 项,每项标明有多少官方依据,其中 7 项用本站的免费工具在 linusseo.com 上做了实测。
做这类体检时,常见的清单把所有检查项写得同样重要,llms.txt、专门给 AI 用的结构化数据和 robots.txt 并列。但是这些检查项的依据差别很大:有的写在 OpenAI、Google 的官方文档里,有的只是行业里流传的做法,Google 2026 年的官方指南甚至明确说不需要做。所以本文在每一项里写明依据来自哪里:厂商的官方文档、第三方研究,还是行业里的做法。
要点
- AI 搜索体检分 4 层:爬虫进不进得来、能不能读到正文、内容用不用得上、有没有被访问和引用。前两层出问题,后面做得再好也没有用。
- 2026 年要先查 CDN 设置,再查 robots.txt。Cloudflare 从 2026 年 9 月 15 日起,「Block」类选项会连 Googlebot 一起拦。
- 爬虫分三类:搜索、用户触发、训练。拦训练爬虫不影响被 AI 搜索引用;用户触发的抓取,OpenAI、Perplexity、Google 都说可能不遵守 robots.txt。
- Google 2026 年的官方指南写明,llms.txt、把内容切成小块、专门的结构化数据都不需要。这几项可以放到最后。
- 第四层现在有了第一方数据:Bing 的 AI 表现报告、GA4 的 AI 助手渠道、Search Console 的生成式 AI 报告。
2026 年做 AI 搜索体检,和以前有什么不同
以前的技术体检只有一个读者,就是 Googlebot。现在要面对几家 AI 公司各自的爬虫,变化主要有四点。
第一,爬虫分成了三类,规则各不相同。 OpenAI 和 Anthropic 的爬虫都按用途分三类:给 AI 搜索建索引的(如 OAI-SearchBot),用户在对话里让 AI 打开网页时用的(如 ChatGPT-User),抓数据训练模型的(如 GPTBot)。Perplexity 只有前两类,它说 PerplexityBot 不用于训练模型。屏蔽 OAI-SearchBot 的网站不会出现在 ChatGPT 搜索的回答里,屏蔽 GPTBot 只表示内容不用于训练。用户触发的抓取另算:OpenAI、Perplexity、Google 都说它们可能不遵守 robots.txt,只有 Anthropic 声明自己的爬虫都遵守。
第二,拦截点从 robots.txt 移到了 CDN。 从 2025 年 7 月起,新接入 Cloudflare 的域名在设置时要选择是否允许 AI 爬虫,默认选项是拦截;2026 年 9 月 15 日起,Cloudflare 的 Block 类选项还会拦 Googlebot、Bingbot 和 Applebot,因为这几个爬虫同时抓搜索和训练数据。所以 robots.txt 写对了,CDN 的一个开关仍可能把网站从 Google 搜索和 AI 搜索里一起拿掉。
第三,爬虫开始用签名证明身份。 Web Bot Auth 让爬虫用密码学签名代替 User-Agent 证明自己是谁,IETF 在 2025 年 10 月为它成立了工作组。ChatGPT 的代理浏览器已经签名;Shopify 从 2026 年 5 月 30 日起对没有签名的机器人限流最严。
第四,第四层有了第一方数据。 2026 年 Bing Webmaster Tools 上线了 AI 表现报告,GA4 加了默认的「AI 助手」渠道,Search Console 加了生成式 AI 表现报告和退出开关。以前想知道有没有被 AI 引用,只能自己去问或者买第三方工具。
给老手:2024–2026 时间线
- 2024-12-17:Vercel 与 MERJ 发布日志分析,主流 AI 爬虫都不执行 JavaScript(Vercel)。
- 2025-07-01:新接入 Cloudflare 的域名在设置时要选择是否允许 AI 爬虫,默认选项是拦截(Cloudflare)。
- 2025-08-29:Shopify 支持商家用 Web Bot Auth 给审计工具授权(Shopify changelog)。
- 2025-09-24:Cloudflare 推出 Content Signals,把用途分成 search、ai-input、ai-train(Cloudflare)。
- 2025-12-09 前后:OpenAI 改写爬虫文档,robots.txt 一节不再覆盖 ChatGPT-User(PPC Land)。
- 2026-02-10:Bing Webmaster Tools 上线 AI Performance 公开预览(Bing)。
- 2026-03-20 前后:Google-Agent 加入 Google 的用户触发抓取器列表(Google)。
- 2026-05-13:GA4 默认渠道组加入 AI Assistant(GA4 帮助)。
- 2026-05-15:Google 发布生成式 AI 功能优化指南(Google)。
- 2026-05-30:Shopify 对未签名的机器人收紧限流(Shopify)。
- 2026-06-03:Search Console 推出生成式 AI 表现报告和退出开关,8 月 31 日覆盖全球(Google)。
- 2026-09-15:Cloudflare 的 Block 类选项开始覆盖 Googlebot、Bingbot、Applebot(Cloudflare)。
体检分四层,先查容易出大问题的
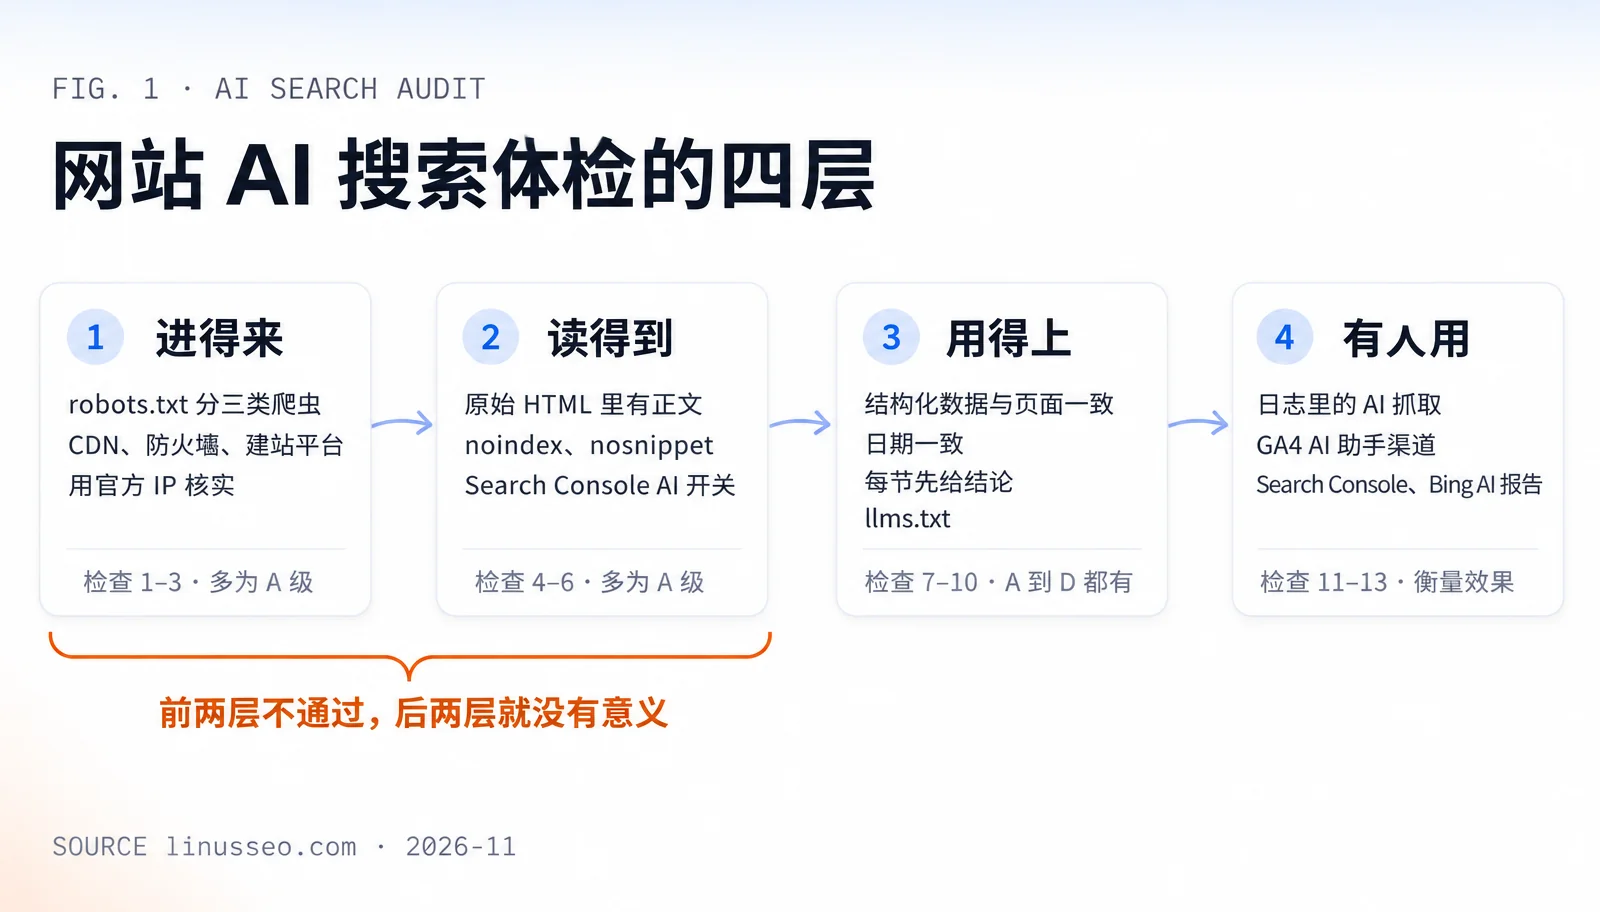
四层有先后顺序。第一层不通过,爬虫拿不到页面;第二层不通过,爬虫拿到的是空壳。所以前两层要先修,它们大多有官方文档作依据。第三层里有官方要求的,也有只是行业做法的,要分清哪些值得花时间。第四层是衡量,确认前面的改动有没有效果。
Google 的 AI Overviews 和 AI 模式用的是 Googlebot 抓取的普通索引。Google 的说明是,出现在这些功能里没有额外要求,页面能被收录、能显示摘要就行。所以下面很多检查项主要是给 ChatGPT、Perplexity、Claude 这些不用 Google 索引的 AI 搜索准备的。
第一层:AI 爬虫进不进得来
1. robots.txt 按三类爬虫分别处理
检查 robots.txt 有没有误拦 AI 搜索爬虫。常见的错误是想禁止训练,结果把 OAI-SearchBot 也写进了 Disallow,或者用 User-agent: * 一刀切。各家爬虫的名称和用途,OpenAI、Anthropic、Perplexity 都在官方文档里列了出来。推荐的写法是放行搜索爬虫和用户触发的爬虫,训练爬虫按你的版权意愿决定。Anthropic 的名字最容易弄混:Claude 搜索用的是 Claude-SearchBot,ClaudeBot 只用于训练。robots.txt 的语法和各家爬虫的写法,可以看我在筋斗云写的《robots.txt 与 Meta Robots 完整指南》。
另外有两个控制令牌,它们不是会来抓网页的爬虫,只是写在 robots.txt 里声明数据用途的名称:
- 屏蔽 Google-Extended 影响 Gemini 等系统的训练和 grounding,不影响 Google 搜索和 AI Overviews。
- 屏蔽 Applebot-Extended 只影响 Apple 模型的训练,不影响 Siri、Spotlight。
用本站的「AI 爬虫 robots.txt 检测」输入域名,再填一篇真实文章的路径,它按 RFC 9309 判断 30 多个爬虫能不能抓这个路径,并标出哪些爬虫的运营方说过可能不遵守 robots.txt。
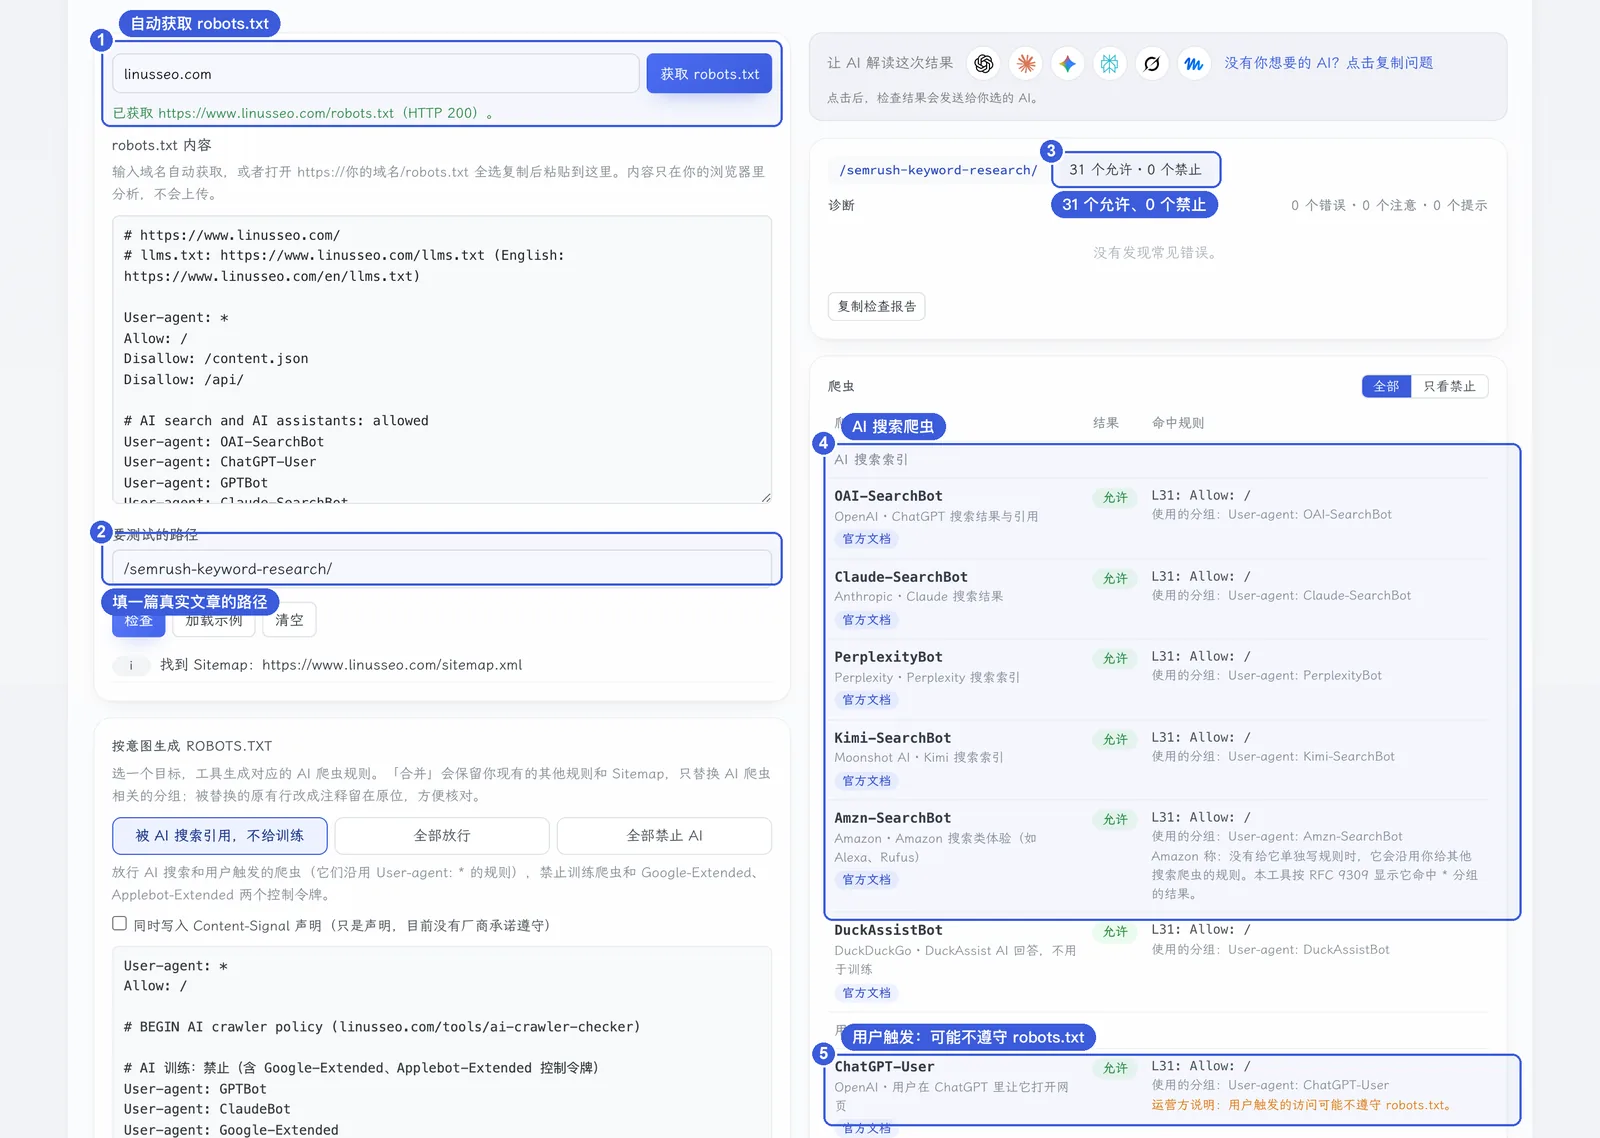
本站结果:31 个爬虫全部允许,没有发现常见错误。
2. CDN、防火墙和建站平台没有拦 AI 爬虫
这一项在 2026 年最重要,Google 的说明也要求在 robots.txt 和「任何 CDN 或托管基础设施」上都允许抓取。要检查的地方:
- Cloudflare:在域名的 AI Crawl Control 里看 Search、Agent、Training 三类的设置。如果选了 Block 或 Block on pages with ads,Googlebot、Bingbot 和 Applebot 也会被拦。只想禁止训练,改用 Disallow AI Training。
- 其他 CDN 和防火墙:查有没有按「机器人」或「AI」分类拦截的规则,以及按 User-Agent 拦截的自定义规则。
- Shopify:店铺的机器人防护会对没有签名的爬虫限流。用 SEO 工具审计自己的店铺时,可以在后台为工具生成 Web Bot Auth 签名。Google-Agent 和 Web Bot Auth 的背景,见我在筋斗云写的《Google-Agent 与 Web Bot Auth》。
本站的「AI 爬虫看到了什么」用普通浏览器、Googlebot 和 5 个 AI 爬虫的 User-Agent 各请求一次网址。浏览器拿到 200、某个 AI 爬虫拿到 403 或验证页,就说明有规则按 User-Agent 拦截。
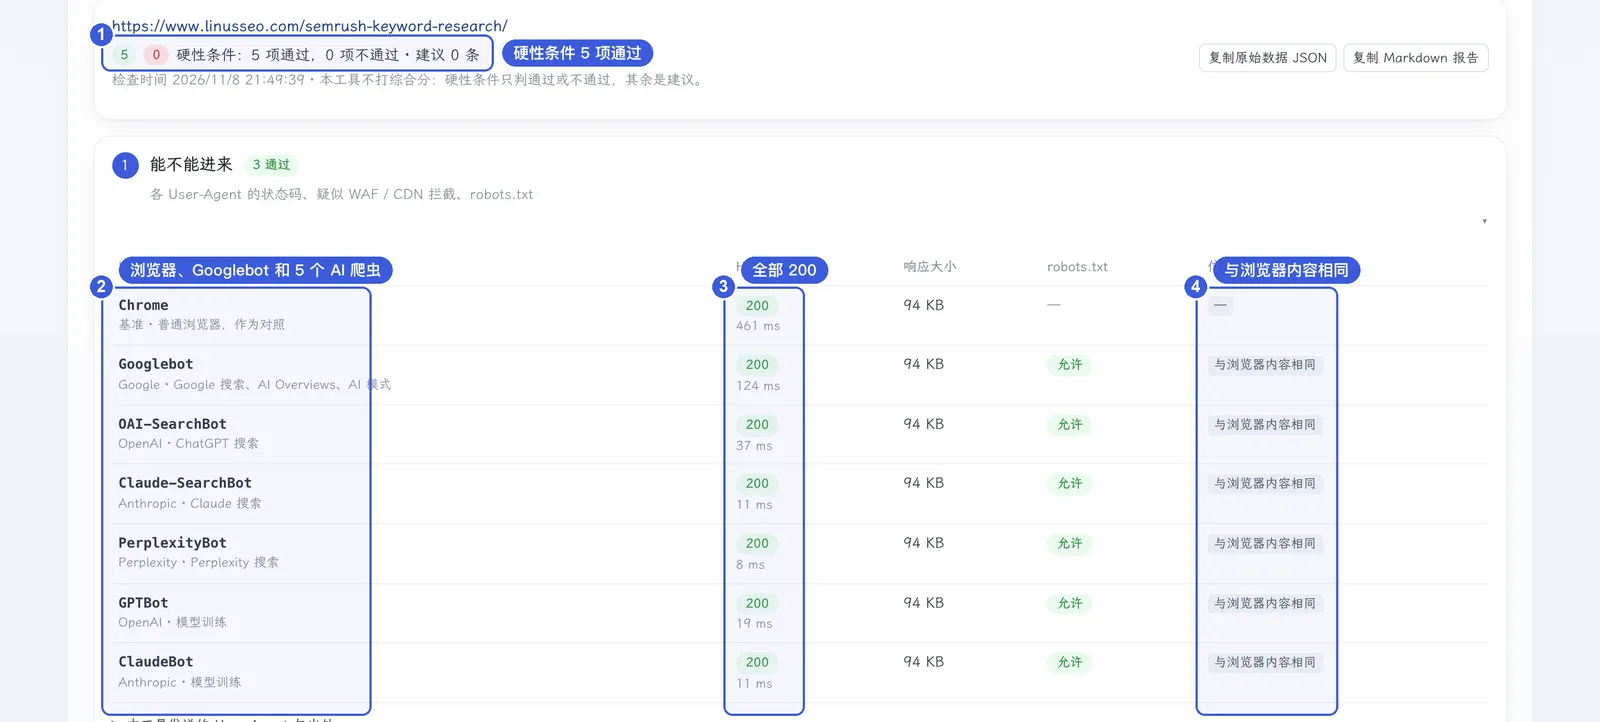
本站结果:7 个 User-Agent 都返回 200,内容和浏览器拿到的逐字节相同,说明本站的托管层没有按 User-Agent 拦截这几个爬虫。
3. 用官方 IP 段核实真实爬虫的访问
第 2 项的模拟只换了 User-Agent,请求的 IP 不在 AI 公司公布的爬虫 IP 段里。很多防火墙同时核对两者,所以模拟通过不等于真爬虫能进来。要确认,就在服务器或 CDN 的访问日志里,按各家公布的 IP 列表筛出真实爬虫的请求,看它们拿到的状态码。
本站的「AI 爬虫日志分析」可以直接拖入访问日志,它按官方 IP 列表区分真爬虫和冒充的请求。User-Agent 谁都可以伪造,只按它统计,可能把冒充的请求也算成 AI 爬虫的访问。
给老手:各家公布的爬虫 IP 列表
- OpenAI:
https://openai.com/searchbot.json、gptbot.json、chatgpt-user.json,2026 年新增adsbot.json(OAI-AdsBot 只访问 ChatGPT 广告的落地页)。 - Perplexity:
https://www.perplexity.ai/perplexitybot.json、perplexity-user.json。 - Google:Googlebot 用反向 DNS 或官方 IP 列表核实;Google-Agent 有单独的
user-triggered-agents.json。 - Anthropic 不建议按 IP 拦截,核实用的列表在
claude.com/crawling/bots.json。 - Apple:反向 DNS 为
*.applebot.apple.com,IP 列表在search.developer.apple.com/applebot.json。
第二层:进来以后能不能读到正文
4. 正文和内链在原始 HTML 里
Vercel 与 MERJ 2024 年分析访问日志后发现,主流 AI 爬虫都不执行 JavaScript,执行的只有 Googlebot(Gemini 也用它)和 Applebot。有个别来源称 OAI-SearchBot 已开始渲染 JavaScript,但 OpenAI 没有公开说明。ChatGPT 的代理浏览器、Google-Agent 这类代用户操作网页的代理是真浏览器,会执行 JavaScript,但给 AI 搜索建索引的仍是不执行 JavaScript 的爬虫。所以靠脚本加载的正文、价格、评价、FAQ,ChatGPT、Claude、Perplexity 的爬虫很可能读不到。这个结论来自第三方研究,AI 公司自己没有说明。渲染方式的选择和迁移,见我在筋斗云写的《JS 渲染与 SEO》。
「AI 爬虫看到了什么」的第二部分只解析原始 HTML,不执行 JavaScript,统计正文字数、标题层级、链接数和 JSON-LD,并显示 AI 爬虫读到的正文开头。把浏览器里全选复制的文本粘进去,还能估算原始 HTML 覆盖了多少内容。
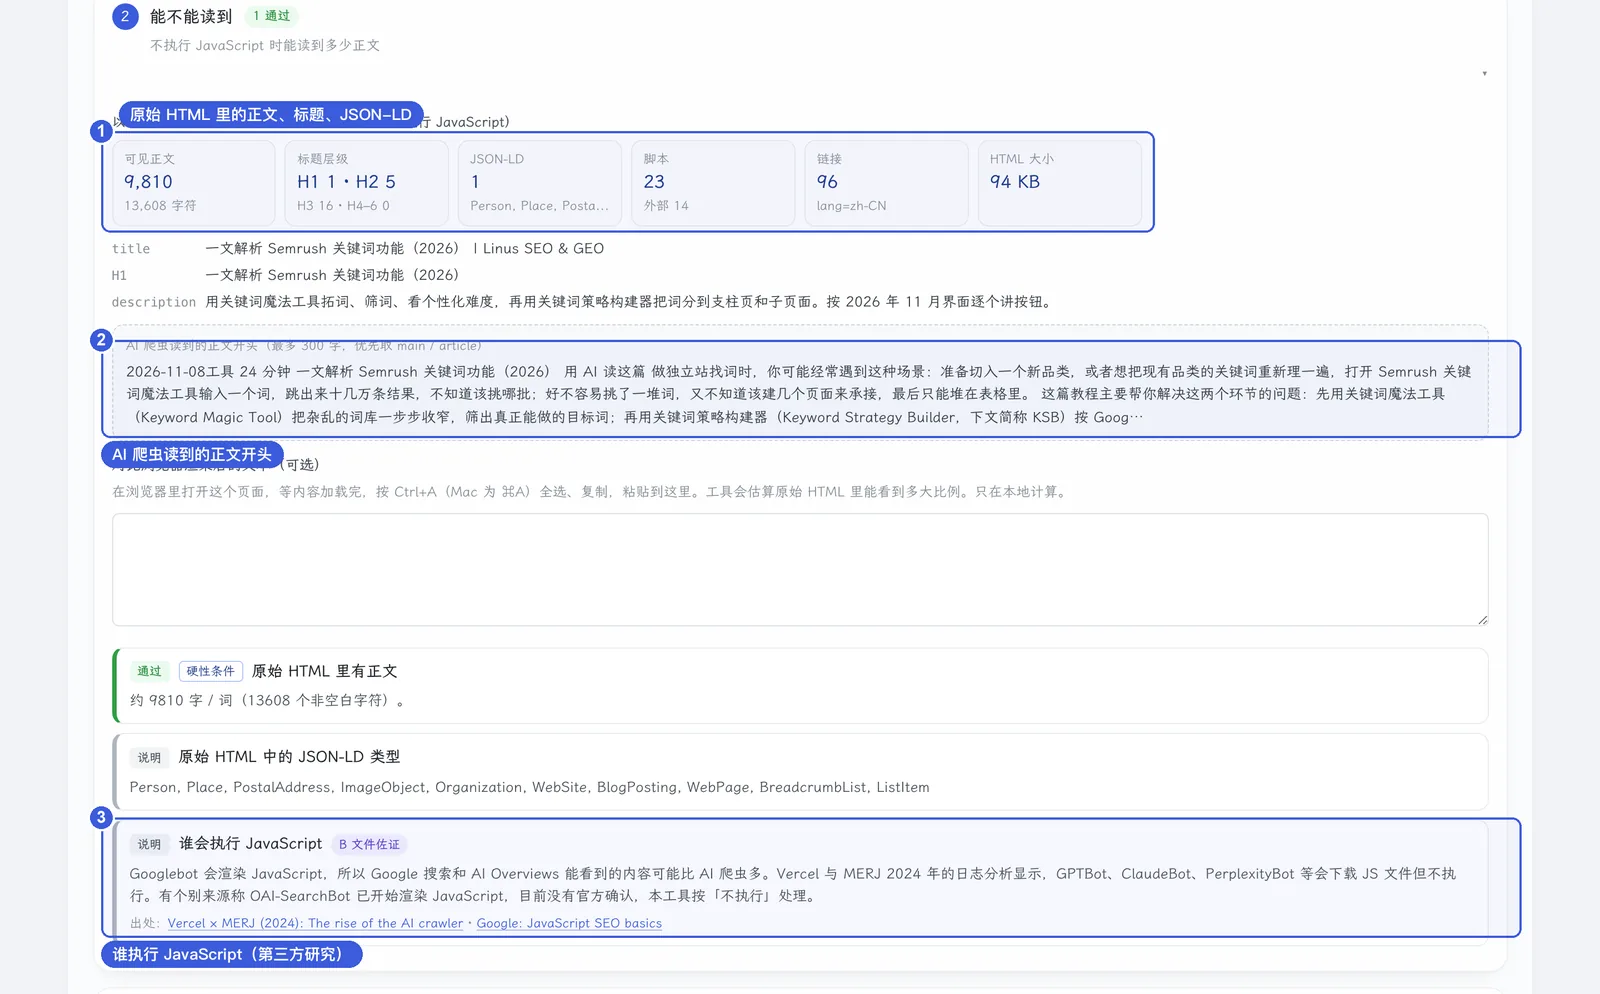
本站结果:《一文解析 Semrush 关键词功能》这篇的原始 HTML 里有约 9,810 字正文、1 个 H1、5 个 H2、16 个 H3 和 96 个链接。本站是 Hexo 生成的静态页面,正文本来就在 HTML 里。但在网站检测那篇中,Semrush 的 JS 影响报告里,193 个页面有 191 个渲染前后有变化,主要是外链数和工具页的字数,所以静态站也值得抽查。
5. 没有误用 noindex、nosnippet 这类指令
这些指令会直接影响 AI 功能能用多少内容:
- Google:按 Google 的 AI 功能说明,
noindex让页面不出现;nosnippet、max-snippet、data-nosnippet限制 AI Overviews 和 AI 模式能引用的文字。 - Bing 和 Copilot:Bing 2026 年的站长指南写明,
NOARCHIVE会让内容不被 Copilot 用来回答,NOCACHE让 Copilot 只能用网址、标题和摘要。但是 Bing 2026 年 10 月 30 日宣布改用ai-training和ai-grounding两项新偏好,2027 年 3 月 1 日以后不再把NOARCHIVE、NOCACHE当作训练和 grounding 的偏好。 - Apple:Apple 2026 年更新的说明写明,
nosnippet也会让内容不被用作 AI 回答的上下文。
检查时重点看模板级的设置,例如某个主题把 max-snippet:0 写进了所有文章页。「AI 爬虫看到了什么」的第三部分会列出页面上的这些指令。
本站结果:文章页的 meta robots 是 index, follow, max-image-preview:large, max-snippet:-1, max-video-preview:-1,没有限制。
6. Search Console 的生成式 AI 开关是「包含」
Search Console 里加了一个开关,可以把网站排除出 AI Overviews、AI 模式和 Discover 里的 AI 功能,2026 年 8 月 31 日起全球可用。Google 的公告说这个开关不影响普通搜索结果的排名,但选了排除,网站就不会从这些 AI 功能里获得展示和流量。接手一个网站时,要确认前任没有关掉它。它不管训练,训练用途仍然由 Google-Extended 控制。
第三层:读到以后用不用得上
7. 结构化数据和页面上看得到的内容一致
Google 的指南说,生成式 AI 搜索不需要结构化数据,也没有专门的 schema.org 标记要加。但是 Google 的结构化数据通用指南要求不标记读者看不到的内容,Bing 2026 年的指南也要求标记如实反映可见内容,并说结构化数据可能让引用更清楚,但不保证可见度。所以这一项检查的是一致性,不需要增加标记的数量:价格、库存、作者、日期在 JSON-LD 和页面上是否相同,同一个作者或品牌在不同页面上的 @id 是否一致。
本站的「Schema 可视化工具」把 JSON-LD 画成关系图并检查常见错误。
要一次比对多个页面的作者和品牌节点,可以用「实体一致性检查」。
8. 页面上的几个日期一致
一个页面通常有好几处日期:JSON-LD 的 datePublished 和 dateModified、meta 标签、页面上显示的日期、sitemap 的 lastmod、HTTP 的 Last-Modified。Google 说只有当 lastmod 一直准确时才会采用它。「AI 搜索更偏好新内容」只是行业里的推测,没有官方说明,所以这一项的价值在于不让系统误判页面的时间,而不是靠改日期争取引用。
「AI 爬虫看到了什么」的第四部分会把 JSON-LD、meta 标签、<time> 标签、页面上显示的日期和 HTTP 的 Last-Modified 列在一起对比。它不读取 sitemap,lastmod 要另外打开 sitemap 核对。
本站结果:结构化数据、meta 和页面显示的日期一致。HTTP 的 Last-Modified 是另一回事:本站托管在 Vercel,2023 年的旧文和几周没改过的头像图片,Last-Modified 都是最近一次部署的当天,所以这个响应头不能用来判断内容新旧。
9. 每一节开头先给结论
行业里普遍建议每个小标题下第一句直接回答、段落不要太长、数字给出处,理由是 AI 常常只引用一段话。这些建议对读者也有好处,但依据只是行业观察;Google 2026 年的指南明确说,不需要为 AI 把内容切成小块或专门改写。所以这一项在改旧文时顺手做即可。
本站的「AI 可引用性检测」把文章按 H2、H3 切开,逐节检查第一句、长度、数字和出处,并说明每条建议的依据。
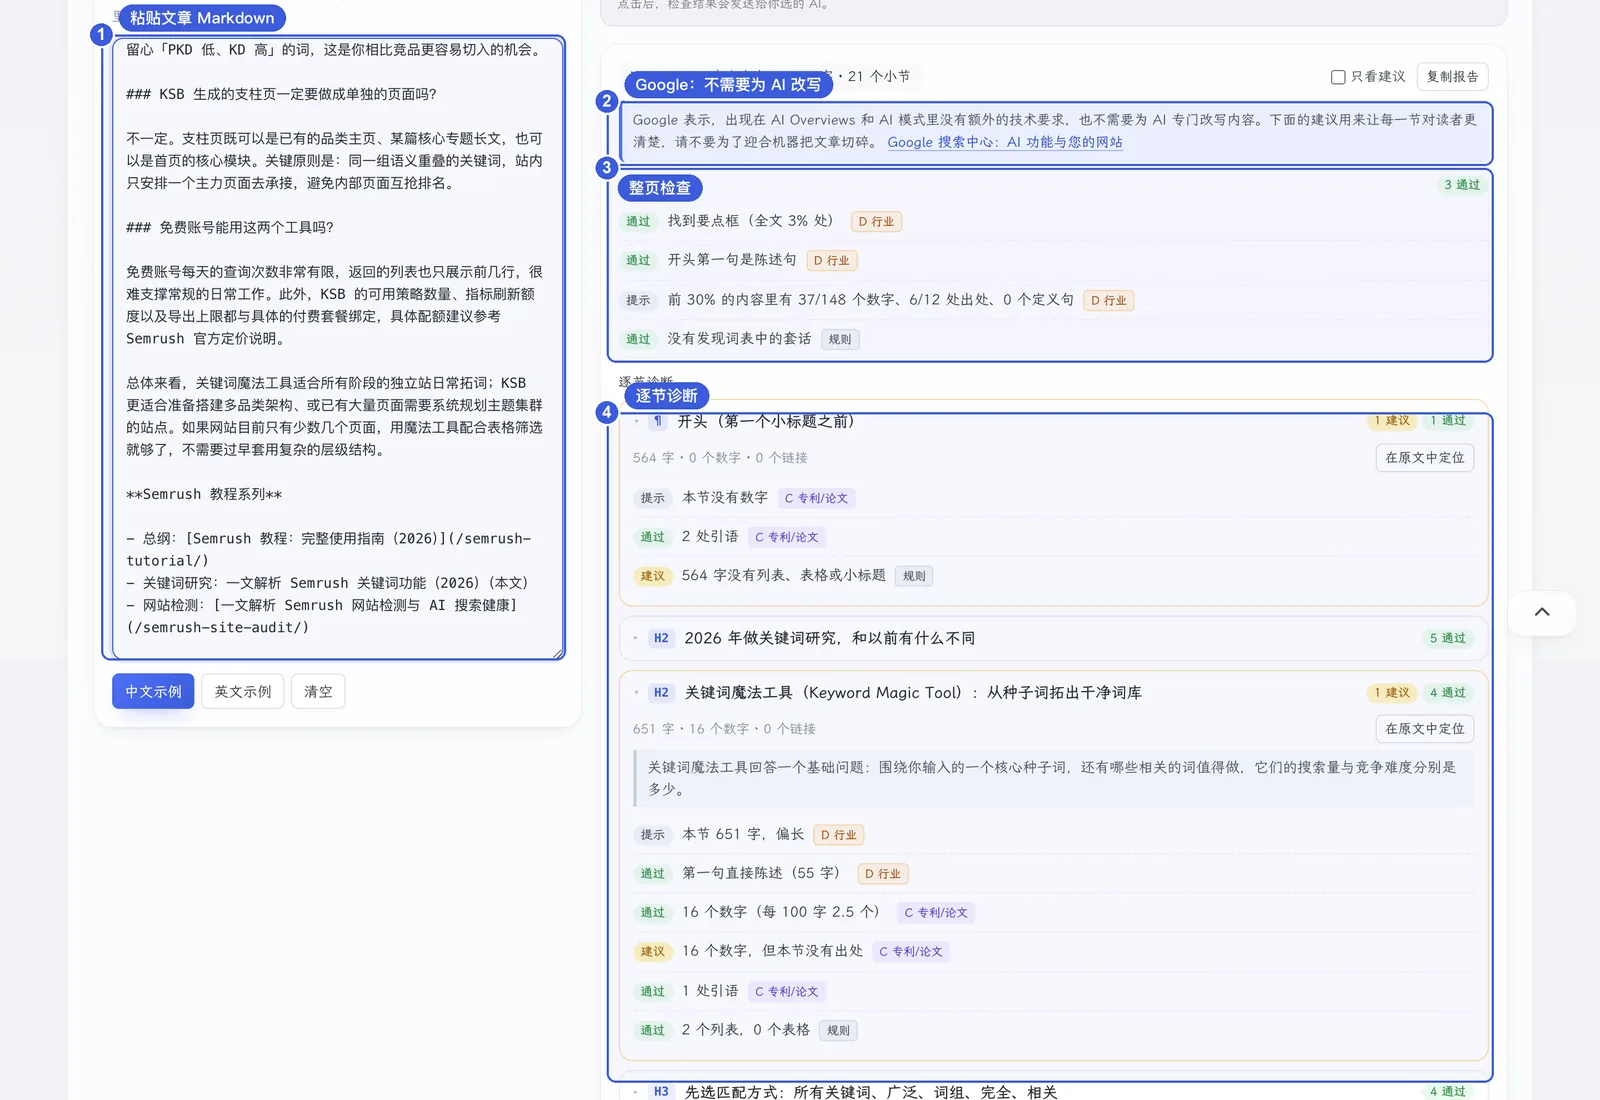
本站结果:《一文解析 Semrush 关键词功能》有要点框,开头第一句是陈述句;建议主要有两类:开头 564 字没有列表或小标题,「关键词魔法工具」一节有 16 个数字但没有出处。
10. llms.txt(可以放到最后)
llms.txt 是放在网站根目录的一份 Markdown 目录,告诉 AI 网站有哪些重要页面。它没有被主流 AI 搜索采用的证据:Google 的 John Mueller 2025 年说过「目前没有 AI 系统使用 llms.txt」,Google 2026 年的指南把它列在不需要做的事里,OpenAI、Anthropic、Perplexity 的爬虫文档都没有提到它。开发者文档、API 文档做一份有一定用处,因为写代码的 AI 助手可能会读;外贸独立站和内容站可以不做。格式可以用本站的「llms.txt 检测与生成」检查。
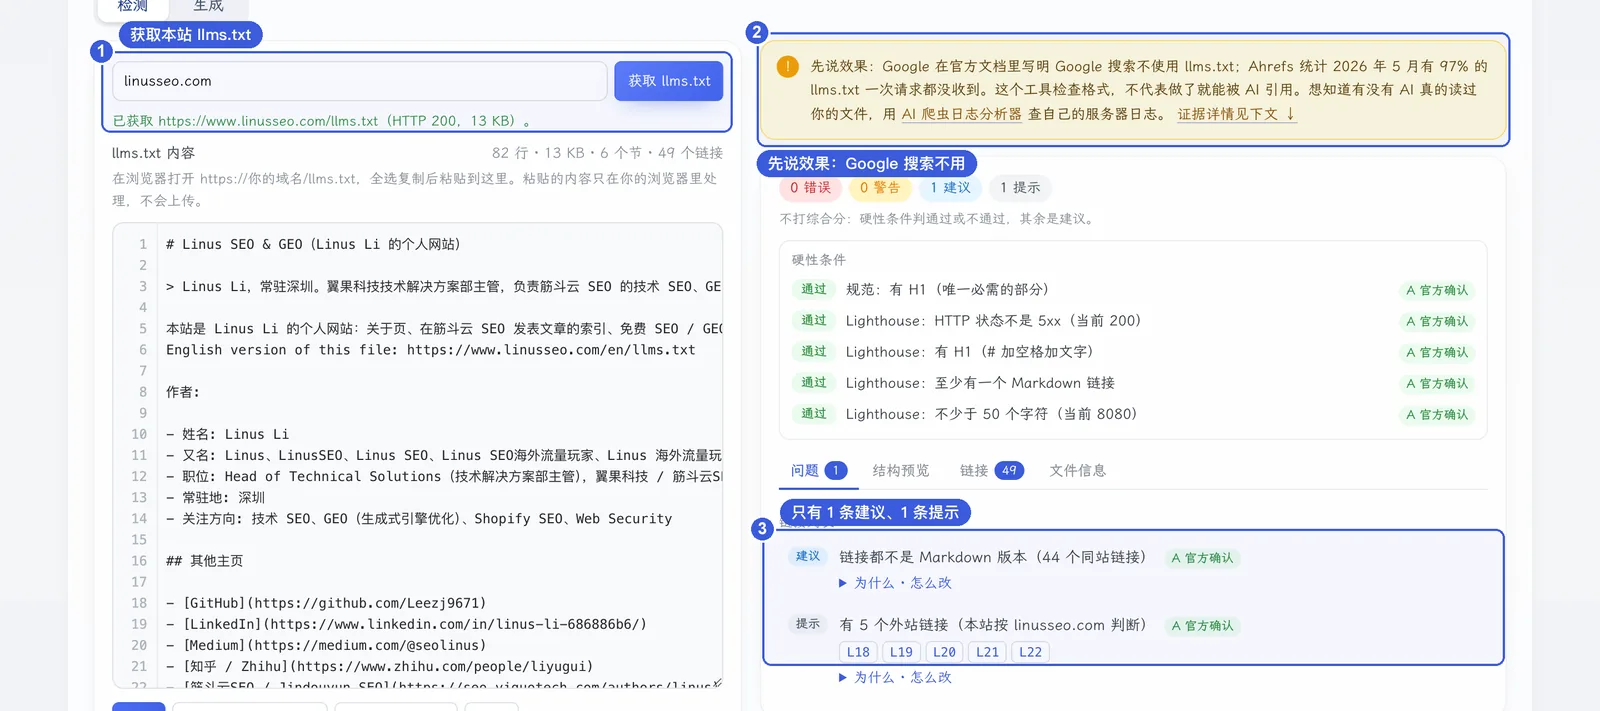
本站结果:本站有 llms.txt,格式检查 0 个错误,1 条建议是链接没有指向 Markdown 版本。本站做它是为了测试工具,不指望它带来引用。
第四层:有没有被访问、被引用
11. 日志里的 AI 爬虫和用户触发的抓取
访问日志能回答两个问题。第一,AI 搜索爬虫有没有来、抓了哪些页面、拿到什么状态码,这能验证第一层的结论。第二,ChatGPT-User、Claude-User、Perplexity-User 这类用户触发的抓取访问了哪些页面。按 OpenAI 等公司的说明,这类请求发生在用户提问、AI 需要打开某个网页时,所以可以推断:被它们频繁访问的页面,就是 AI 回答问题时实际用到的页面。这是本文的推断,厂商没有公布这类请求和最终引用之间的对应关系。
12. GA4 里的 AI 助手流量
按 GA4 帮助中心的说明,GA4 从 2026 年 5 月 13 日起有了默认的「AI Assistant」渠道:来源是被识别的 AI 助手时,媒介自动设为 ai-assistant。Google 没有公开完整的 AI 助手名单;按第三方的测试,这个渠道不回溯历史,没有来源信息的访问仍会算进直接流量。ChatGPT 的链接会带 utm_source=chatgpt.com,所以 ChatGPT 的流量比较好识别。2026 年 6 月 GA4 又加了「来源组」维度,主要用来把社交媒体等来源按平台归组,也内置了 ChatGPT、Perplexity 的分组。
想补上默认渠道没覆盖的来源(例如 Kimi、豆包),用本站的「AI 流量归因:GA4 / Shopify 规则生成器」勾选来源,生成 GA4 自定义渠道组的正则,也能生成 Looker Studio、GTM 和服务器日志的写法。
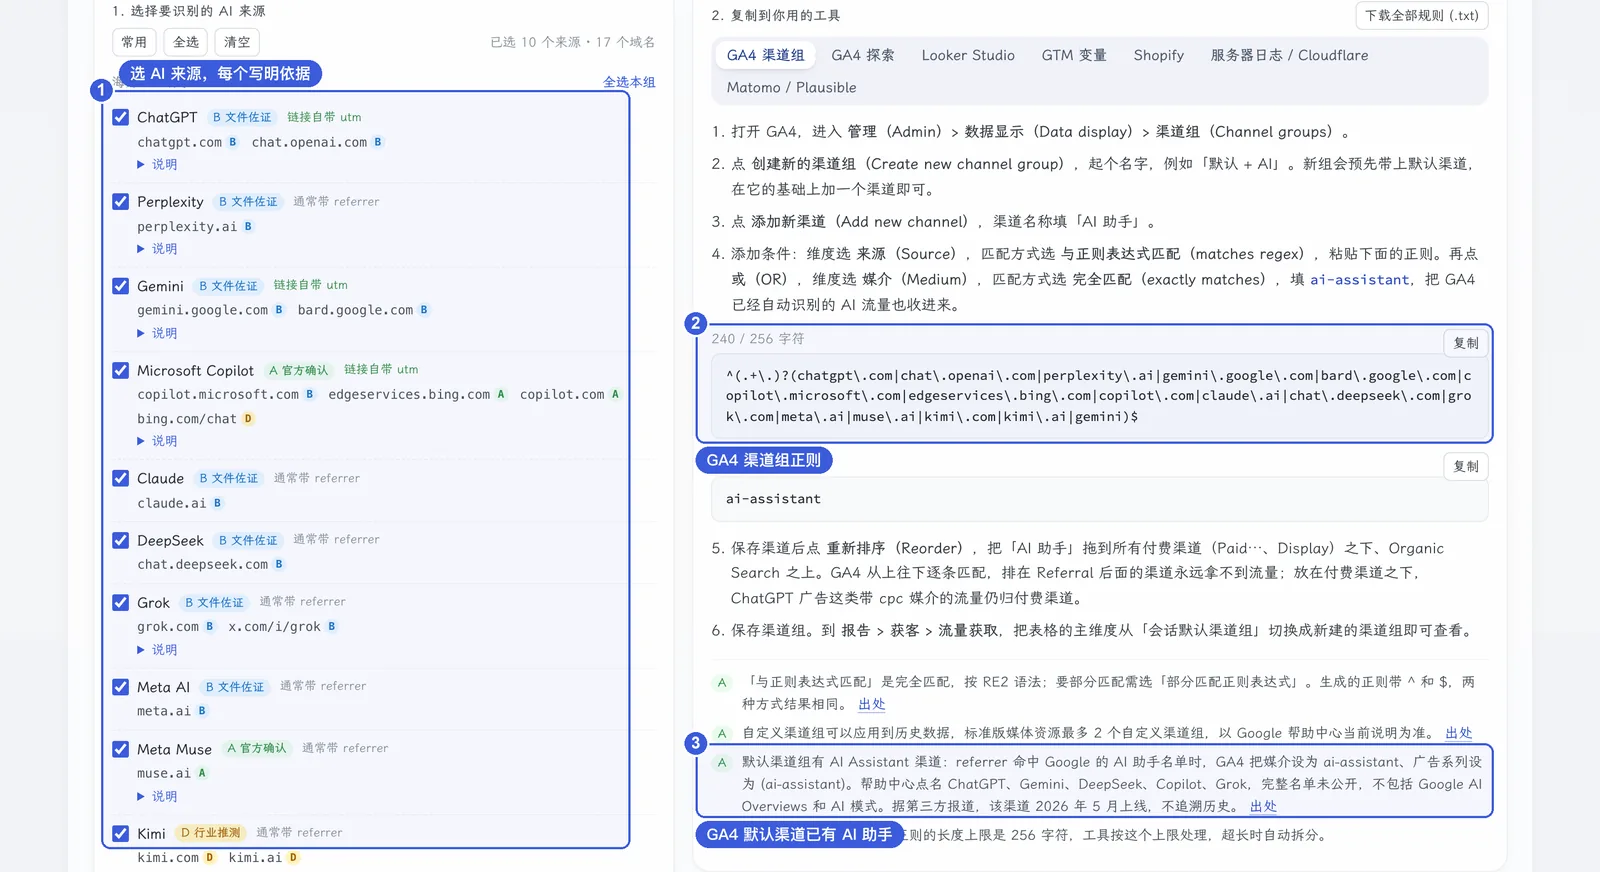
13. Search Console 和 Bing 的 AI 报告
- Bing Webmaster Tools 的 AI Performance:Bing 官方博客 2026 年 2 月宣布上线公开预览,显示网站在 Copilot 和 Bing AI 摘要里被引用的次数、被引用的页面和 grounding 查询(AI 检索内容时用的关键词),据第三方报道 6 月又加了引用份额。没有点击数据。Bing 这份报告的解读,见我在筋斗云写的《Bing 把「被 AI 引用」做成了第一方数据》。
- Search Console 的生成式 AI 表现报告:Google 2026 年 6 月在 Search Central 博客上宣布推出,8 月 31 日覆盖全球,显示网站在 AI 功能里的展示次数,可以按页面、国家、设备看。它没有查询词和点击,AI Overviews 和 AI 模式合在一起,这部分数据同时也算在普通效果报告里。
这两份报告能看到哪些页面被 AI 用到,看不到点击,点击要回到 GA4 看。
13 项检查一览
| 层 | 检查项 | 依据 | 本站工具 | linusseo.com 结果 |
|---|---|---|---|---|
| 进得来 | 1. robots.txt 按三类爬虫处理 | 官方文档 | AI 爬虫 robots.txt 检测 | 31 个允许 |
| 进得来 | 2. CDN、防火墙、平台没有拦截 | 官方文档 | AI 爬虫看到了什么 | 7 个 UA 都是 200 |
| 进得来 | 3. 用官方 IP 核实真实爬虫 | 官方文档 | AI 爬虫日志分析 | 未查 |
| 读得到 | 4. 正文和内链在原始 HTML 里 | 第三方研究 | AI 爬虫看到了什么 | 约 9,810 字 |
| 读得到 | 5. 没有误用 noindex、nosnippet | 官方文档 | AI 爬虫看到了什么 | 无限制 |
| 读得到 | 6. Search Console 生成式 AI 开关 | 官方文档 | Search Console | 未放数据 |
| 用得上 | 7. 结构化数据与可见内容一致 | 官方文档 | Schema 可视化工具、实体一致性检查 | 未单独检查 |
| 用得上 | 8. 日期信号一致 | 官方文档 | AI 爬虫看到了什么 | 一致,Last-Modified 不可用 |
| 用得上 | 9. 每节开头先给结论 | 行业做法 | AI 可引用性检测 | 2 类建议 |
| 用得上 | 10. llms.txt | 行业做法 | llms.txt 检测与生成 | 0 错误 |
| 有人用 | 11. 日志里的 AI 抓取 | 官方文档 | AI 爬虫日志分析 | 未查 |
| 有人用 | 12. GA4 AI 助手流量 | 官方文档 | AI 流量归因:GA4 / Shopify 规则生成器 | 未放数据 |
| 有人用 | 13. Search Console、Bing AI 报告 | 官方文档 | Search Console、Bing | 未放数据 |
对你意味着什么
- 先查 CDN 和防火墙,再查 robots.txt。 用 Cloudflare 的网站,去 AI Crawl Control 确认没有选会拦 Googlebot 的 Block 选项;Shopify 店铺留意机器人防护对第三方工具的影响。
- 只屏蔽训练爬虫,放行搜索爬虫。 不想被拿去训练,就屏蔽训练爬虫和 Google-Extended 这类控制令牌,放行搜索和用户触发的爬虫,这不影响被 AI 搜索引用。
- 正文要在原始 HTML 里。 靠前端框架或应用插件加载内容的网站,至少抽查产品页、分类页、文章页三种模板。
- 把只是行业做法的项目(第 9、10 项)放到最后,先接上第四层的数据。 改了前三层以后,过几周到 Bing、Search Console 的 AI 报告和 GA4 的 AI 助手渠道里看有没有变化。
常见问题
屏蔽 Google-Extended 能退出 AI Overviews 吗?
不能。Google-Extended 只控制 Gemini 的训练和 grounding,不影响 Google 搜索,也不影响 AI Overviews 和 AI 模式。想退出 AI Overviews 和 AI 模式,要用 Search Console 的生成式 AI 开关,或者 nosnippet、noindex,后两者也会影响普通搜索结果。
robots.txt 能挡住 ChatGPT 打开我的网页吗?
挡不住全部。robots.txt 能管住 OAI-SearchBot 和 GPTBot,但 OpenAI 说用户触发的 ChatGPT-User 可能不遵守 robots.txt,Perplexity-User 和 Google-Agent 也一样。只有 Anthropic 声明 Claude-User 遵守 robots.txt。真要拦,只能在服务器或 CDN 上按官方 IP 段拦。
体检都通过了,为什么还是没被引用?
这份清单只检查 AI 能不能拿到并使用你的内容。能不能被引用,还取决于内容本身有没有别人没有的信息、品牌在其他网站上有没有被提到,以及各家 AI 的检索系统怎么选来源。
附录:出处
| 判断 | 依据 | 出处 |
|---|---|---|
| 屏蔽 OAI-SearchBot 的网站不会出现在 ChatGPT 搜索回答里;GPTBot 只用于训练 | 官方文档 | OpenAI 爬虫文档 |
| ChatGPT-User 可能不遵守 robots.txt(2025-12 改写) | 官方文档 | OpenAI 爬虫文档;PPC Land 2025-12-09 |
| Anthropic 三个爬虫都遵守 robots.txt;ClaudeBot 用于训练 | 官方文档 | Anthropic 帮助中心 |
| Perplexity-User 通常不遵守 robots.txt | 官方文档 | Perplexity 文档 |
| Google 用户触发的抓取器(含 Google-Agent)通常不遵守 robots.txt | 官方文档 | Google 抓取器文档 |
| Google-Extended 不影响网站在 Google 搜索中的收录 | 官方文档 | Google 常见爬虫文档 |
| Applebot-Extended 不抓取网页,只控制训练用途 | 官方文档 | Apple 支持 |
| AI Overviews、AI 模式没有额外要求;要在 robots.txt 和 CDN 上允许抓取 | 官方文档 | Google:AI 功能与您的网站 |
| 不需要 llms.txt、专门的标记或把内容切成小块;结构化数据不是必需的 | 官方文档 | Google 生成式 AI 优化指南 |
| 不标记读者看不到的内容;标记要如实反映可见内容 | 官方文档 | Google 结构化数据通用指南;Bing 站长指南 |
| Search Console 的生成式 AI 开关可以退出 AI Overviews、AI 模式和 Discover 里的 AI Overviews,不作为普通搜索结果的排名信号 | 官方文档 | Google 博客 2026-06-03 |
| Search Console 生成式 AI 报告只有展示,没有查询和点击 | 官方文档 | Search Central 博客 2026-06 |
| Cloudflare 的 Block 类选项自 2026-09-15 起覆盖 Googlebot、Bingbot、Applebot | 官方文档 | Cloudflare 博客 2026-09-15 |
| Bing 与 Copilot 共用抓取和索引;NOARCHIVE 让内容不被 Copilot 使用 | 官方文档 | Bing 站长指南 |
| Bing 改用 ai-training、ai-grounding 偏好,2027-03-01 以后不再把 NOARCHIVE、NOCACHE 当作训练和 grounding 的偏好 | 官方文档 | Bing 博客 2026-10-30 |
| GA4 默认渠道组有 AI Assistant,媒介为 ai-assistant | 官方文档 | GA4 帮助:新功能 |
| sitemap 的 lastmod 只在一直准确时被采用 | 官方文档 | Google:构建站点地图 |
| 主流 AI 爬虫不执行 JavaScript | 第三方研究 | Vercel × MERJ 2024-12 |
| 用户触发抓取频繁访问的页面就是 AI 回答时用到的页面 | 本文推断 | 本文依据各家对用户触发抓取的说明推断 |
| 每节开头给结论更容易被引用;AI 偏好新内容 | 行业做法 | 行业观察与相关性研究,没有官方说明 |
| llms.txt 能提高其他 AI 搜索的引用 | 行业做法 | 没有证据支持;Mueller 2025-06 称目前没有 AI 系统使用它 |
网站 AI 搜索体检清单:13 项检查与官方依据