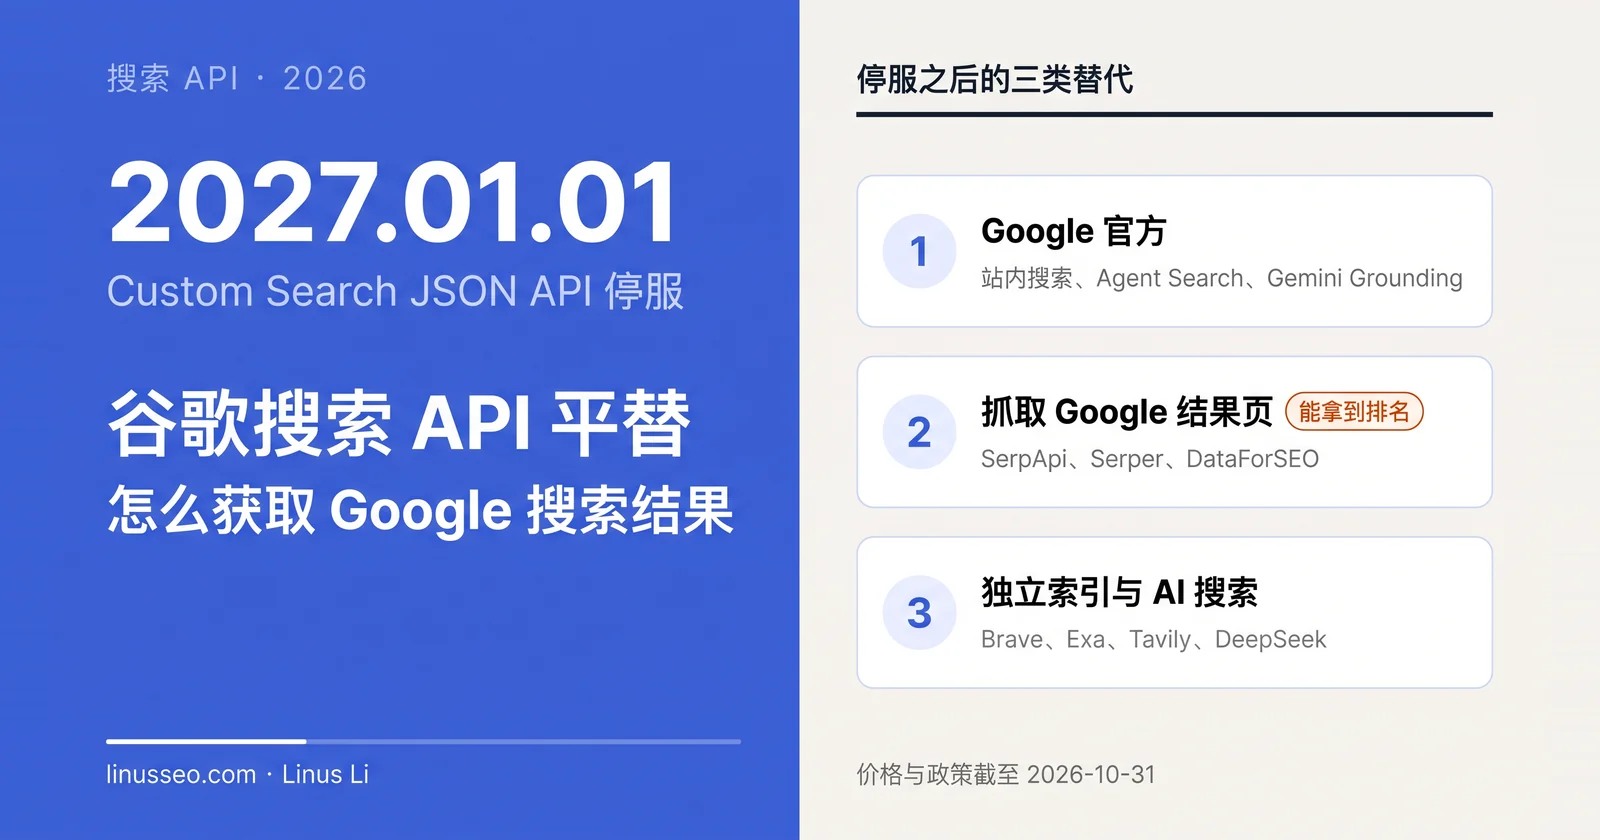
谷歌搜索 API 平替:停服后怎么获取 Google 搜索结果


我在 NeverSec 时代写过一篇笔记,讲怎么用 Google 的 Custom Search JSON API 拿搜索结果。这个接口现在已经不接受新客户,并将在 2027 年 1 月 1 日停服。最近不少做 SEO 工具、数据抓取和 AI 应用的朋友在问同一个问题:停服以后,拿什么替代 Google 搜索?
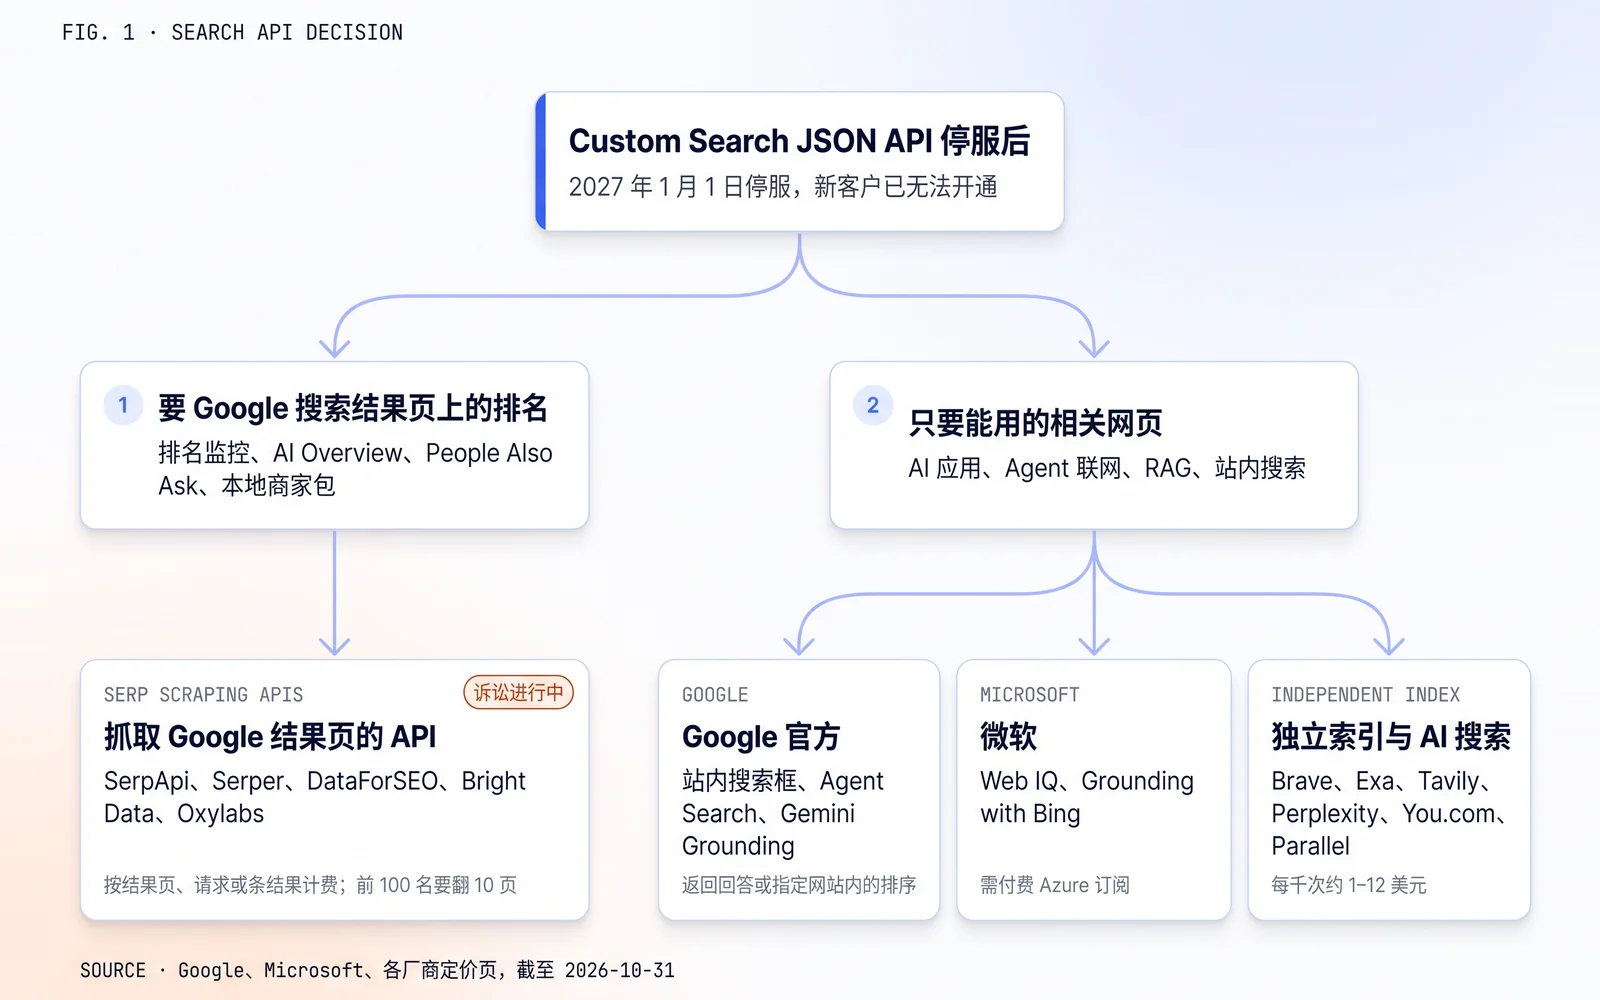
截至 2026 年 10 月 31 日,Google 官方并没有一个能自助开通、直接返回全网搜索排名的 API。 很多团队直到旧接口停服才意识到:Custom Search JSON API 虽然叫 Custom Search,但当年被大量当成轻量级 SERP 接口使用。现在官方把路堵死,核心的分水岭只有一条:你到底是要 Google SERP 上的真实排名,还是只要模型能阅读的网页数据?
如果是前者(排名监控、SERP 特征追踪、竞品可见性分析),市面上任何官方 Grounding 接口都给不了,必须走抓取 Google 结果页的第三方通道;如果是后者(Agent 联网、知识库 RAG 检索),选用自建索引的搜索 API 往往更便宜、响应更快,也没有法务风险。
如果你只想尽快拿到搜索结果,直接看下一节的提示词。
TL;DR:复制提示词,让 AI 帮你接入
如果你不想手动写代码调试,把下面的提示词交给本地的 AI 编程工具(如 Claude Code、Codex、Kimi Code)。替换方括号里的参数后,它能在本地建好环境、处理鉴权、写好请求逻辑,并把数据导出成表格。
1 | 你是一名熟悉搜索 API 的开发助理。Google 的 Custom Search JSON API 已不接受新客户,并将在 2027 年 1 月 1 日停服。请帮我用第三方搜索 API 拿到搜索结果,并保存成表格。 |
在实际跑脚本时,有三个工程细节要提前注意:
- 抓取接口返回的是某台代理节点在某一时刻抓到的 HTML 解析数据。遇到 Google 反爬拦截(如 SearchGuard 质询),返回的 JSON 结构可能缺失部分字段,让 AI 写脚本时务必加入空值容错和重试间隔。
- 批量处理关键词时如果没加流控,脚本很容易在几秒内耗尽供应商的单日免费额度(如 SerpApi 每月仅 250 次),第一次试跑一定要限制单次请求量。
- API Key 务必写在本地
.env并加入.gitignore,切忌直接作为字符串贴给云端对话模型。
给老手:不用 AI,直接 curl
Serper(Google 结果页,gl 是国家,hl 是语言):
1 | curl -X POST 'https://google.serper.dev/search' \ |
SerpApi(Google 结果页):
1 | curl --get 'https://serpapi.com/search.json' \ |
Tavily(相关网页和正文片段):
1 | curl -X POST 'https://api.tavily.com/search' \ |
参数以各家文档为准,发布前按文档再核一次。
下面展开讲搜索 API 现在的市场情况:Google 和微软官方给了哪些路,第三方服务各有什么限制,以及该怎么选。
要点
- Custom Search JSON API 已不接受新客户,现有客户最晚用到 2027 年 1 月 1 日。Google 给的官方替代是站内搜索组件、Agent Search(原 Vertex AI Search)、Gemini 的 Grounding with Google Search,以及需要申请的“全网搜索方案”。
- 这些官方方案都不返回 Google 搜索结果页上的排名。要做排名监控、看 AI Overview 和 People Also Ask,只能用 SerpApi、DataForSEO 这类抓取 Google 结果页的第三方 API。
- 抓取类 API 有法律风险。Google 在 2025 年 12 月起诉 SerpApi,2026 年 7 月法院驳回了 Google 的部分主张,但 Google 已修改诉状,案件没有结束。
- 做 AI 应用、Agent 联网和 RAG,一般不需要 Google 的排名。Brave、Exa、Tavily、Perplexity、You.com、Parallel 和微软 Web IQ 都能用,每千次 1 到 12 美元。
- 各家计费单位不同:按查询、按 prompt、按结果页、按条结果、按 credit 都有。比价前先换算成同一个单位。
旧接口停在哪一天
Custom Search JSON API 的停服分两步。2026 年 1 月 20 日,Google 在 Programmable Search Engine 官方博客宣布调整搜索产品;随后 API 文档改为不接受新客户。时间线如下:
| 日期 | 发生了什么 |
|---|---|
| 2026-01-20 | 新建的 Programmable Search Engine 只能用“Sites to search”,最多指定 50 个域名。已经开启“Search the entire web”的旧引擎可以用到 2027-01-01。需要全网搜索的客户填写 Google 的兴趣表 |
| 2026-02-18 前后 | API 文档写明 Custom Search JSON API 不再接受新客户 |
| 2027-01-01 | Custom Search JSON API 停止服务,现有客户必须完成迁移 |
现有客户在停服前仍按旧价格计费:每天免费 100 次,超出部分每千次 5 美元,每天最多 10,000 次。这组价格只对现有客户有效。新项目即使还能看到文档里的价格,也已经无法开通。
给老手:官方原文与“全网”选项的细节
API 概览页(developers.google.com/custom-search/v1/overview)原文:
The Custom Search JSON API is closed to new customers. Vertex AI Search is a favorable alternative for searching up to 50 domains. Alternatively, if your use case necessitates full web search, contact us to express your interest in and get more information about our full web search solution. Existing Custom Search JSON API customers have until January 1, 2027 to transition to an alternative solution.
“Search the entire web”选项:2026-01-20 之后新建的引擎不能再选;之前已开启的可以保留到 2027-01-01。Google 产品社区里,Google 的社区经理答复过“关闭后无法重新打开”。这条来自社区答复,不是正式文档,所以如果你还开着这个选项,不要随手关掉。
Custom Search JSON API 和更早的 Site Restricted JSON API 是两个产品,后者有过单独的停服公告,不要混在一起。
先分清:你要 Google 的排名,还是能用的网页
我把替代方案按返回的内容分成两类。
第一类返回 Google 搜索结果页的快照。你给出关键词、国家、语言和设备,它返回 Google 当时那一页上的自然结果、广告、AI Overview、People Also Ask 和本地商家包,每条结果带排位。做 SEO 排名监控、SERP 功能分析、竞品可见性追踪都需要这一类。市面上没有任何官方接口提供这类数据,只能依赖第三方抓取服务。
第二类返回 一组相关网页。数据源可能来自 Google 索引(Grounding with Google Search)、Bing 索引(Web IQ),或者各家自建的独立索引(Brave、Exa、DeepSeek 等)。结果顺序是该检索系统自己的相关性打分,和 Google 搜索结果页上的自然排名没有直接对应关系。AI 应用、Agent 联网检索、知识库 RAG 用的是这一类。
这两类的底层逻辑完全不同。Google 的搜索结果页是混合了个性化权重、本地坐标(UULE)、端设备特征以及大量交互组件的展示系统;而 Grounding 类接口只提供供大模型参考的事实片段,官方刻意剥离了所有排位信息以防止被用于逆向排名。你想知道“yoga mat”在美国 Google 上自然排名第 3 是谁,必须用第一类;如果只是做客服机器人解答“瑜伽垫怎么清洗”并附上出处,第二类不仅成本低得多,而且响应更快、合规风险更小。
我在做 DeepSeek 搜索 API 实测时对比过两类结果。378 个查询里,DeepSeek 和 Google 返回的网址几乎不重合(网址 Jaccard 相似度仅 0.006),但在前 5 条内容的相关性盲评中两者打平。这是因为 Google 首页高度偏向积累了多年权重的权威域(维基百科、论坛、头部媒体),而新一代 AI 检索更倾向于召回语义匹配度高、结构干净的长尾页面。做 SEO 监控认的是 Google 权威排名,做 AI 应用认的是答案相关性。完整的实测报告我会单独发布。
AI 工具里的搜索是怎么来的
很多人第一次接触搜索 API,是因为 Claude Code、Codex 这类 AI 编程工具要联网。这些工具自带的搜索,数据来源各不相同:
| 工具 | 自带搜索的数据来源 |
|---|---|
| Claude Code | Anthropic 的搜索后端,官方写明不能更换 |
| Codex | 默认查 OpenAI 维护的缓存索引,可切换为实时联网 |
| DeepSeek Harness | DeepSeek 自家的搜索引擎 |
| Gemini CLI | Google 搜索 grounding,返回回答和出处 |
| Kimi Code | 月之暗面的搜索服务 |
| Pi | 没有自带搜索 |
AI 工具联网时,模型先写出搜索词,工具把搜索词发给某个搜索服务,拿回标题、网址和摘要,模型读完再写回答。搜索服务就是本文讲的这些 API。所以,在这些工具里想拿到 Google 结果页的排名,也要另外接 SerpApi 这类抓取服务。 每个工具的具体配置方法,见《Claude Code、Codex、DeepSeek Harness 怎么接入谷歌搜索》。
Google 官方的四条路
Google 给 Custom Search JSON API 用户指了四条路。它们分别对应站内搜索、固定域名搜索、模型联网和全网搜索,没有一条能直接替代旧接口返回全网结果列表的功能。
| 方案 | 适合做什么 | 价格 | 能否拿到 Google 排名 |
|---|---|---|---|
| Programmable Search Element | 网站上的搜索框 | 标准版免费,带广告 | 否 |
| Agent Search(原 Vertex AI Search) | 程序化搜索指定网站 | 每千次 1.5 或 4 美元 | 否 |
| Grounding with Google Search | 让 Gemini 联网回答并附出处 | Gemini 3:每千次搜索 14 美元 | 否 |
| 全网搜索方案 | 全网搜索 | 未公开 | 未公开 |
Programmable Search Element:只管站内搜索框
如果你的需求只是给网站加一个搜索框,用 Programmable Search Element 就够了。它是一段 JavaScript,在浏览器里显示结果,不用自己写结果页。
标准版免费,没有每日查询上限,但结果页可能显示广告。符合条件的非营利组织、学校和政府机构可以申请无广告版本。原来每千次 5 美元的付费无广告版(Paid Element)也已经不接受新客户。
使用条款对展示有要求:保留 Google 的品牌标识,不改结果顺序,不把结果和其他内容混排,不缓存或转存结果。所以它只能当站内搜索框用,不能当数据源。
Agent Search:搜几十个固定网站
如果应用需要用代码查询一组固定网站,例如自己的几个站点、行业里的几十个权威站,可以用 Agent Search。这个产品原来叫 Vertex AI Search,2026 年改名为 Agent Search,文档里两个名字都会出现。
价格按查询次数计:
- Standard 版:每千次 1.5 美元;
- Enterprise 版:每千次 4 美元。网站搜索(Website Search)只在 Enterprise 版里,所以替代 Custom Search 一般按 4 美元算;
- 生成式答案高级版(Advanced Generative Answers):每千次再加 4 美元;
- 每个账号每月有 10,000 次免费试用,不含生成式答案高级版;索引和存储另外收费。
Google 的迁移文档建议:建一个 Enterprise 版的搜索应用和“网站内容”数据存储,填入要搜索的网址规则,关闭生成式回答和高级网站索引,再用 searchLite 或 search 接口调用。这样返回的结果最接近旧接口。
关于范围限制,有两种说法。Google 的公告写的是“最多 50 个域名”,Agent Search 的数据文档写的是基础网站索引最多 50 条网址规则(URL patterns),高级网站索引最多 500 条。两者不是同一个限制,建应用前按你的数据存储类型核对。
Agent Search 返回结果的顺序,是它在你指定网站范围内的相关性排序。 第 1 条结果不代表这个页面在 Google 搜索里排第 1。
给老手:返回字段与迁移步骤
SearchResponse 的 results[] 里常用的字段有 document、derivedStructData(含 title、link、snippets、extractive_segments)。开启生成式回答后另有 summary 和引用。字段结构和旧接口的 items[].title / link / snippet 不同,迁移时要改解析代码,只换请求地址不行。
迁移文档(docs.cloud.google.com/generative-ai-app-builder/docs/migrate-from-cse)的步骤:启用 Agent Search → 建 Search App → 开 Enterprise 版 → 关 Generative Responses → 建 Website Content 数据存储 → 关 Advanced website indexing → 填 URL patterns → 用 searchLite(API key)或 search(OAuth)调用。
价格页原文:Standard“$1.50 / 1,000 query”,Enterprise“$4.00 / 1,000 query”,Advanced Generative Answers“+$4.00 / 1,000 user input query”,免费试用“10,000 queries per account, per month … Excludes Advanced Generative Answers”。
Grounding with Google Search:让 Gemini 联网回答
Grounding with Google Search 是 Gemini API 的一个工具。你把问题发给 Gemini,模型自己决定搜什么,然后返回一段回答和引用来源。它用 Google 的搜索结果,但只返回模型写好的回答和来源,不返回结果列表。
计费方式在 Gemini 2.5 和 Gemini 3 之间变了:
| 模型 | 计费单位 | 价格 | 免费额度(Gemini API 付费层) |
|---|---|---|---|
| Gemini 3 及之后 | 模型实际执行的每一次搜索 | 每千次 14 美元 | 每月 5,000 次,所有 Gemini 3 模型共用;默认每个项目每天最多 1,500 次 |
| Gemini 2.5 | 每个联网的 prompt | 每千次 35 美元 | 每天 1,500 次;Flash 和 Flash-Lite 共用额度 |
Gemini 3 按搜索次数计费,一个问题可能触发好几次搜索。 例如用户问“某公司创始人哪年出生、公司哪年上市”,模型可能分两次搜索,按两次计费。估算成本时,要按实际搜索次数算,不能按用户提问次数算。
使用条款有三条要注意:
- 生产环境必须显示 Google 返回的搜索建议(Search Suggestions),点击后直接打开 Google 搜索结果页,中间不能加跳转页。
- 不能缓存、转售结果,不能用结果训练模型,不能用结果里的链接去批量抓取网页、建自己的索引。
- 回答里的来源链接要显示给用户。
所以它适合做带出处的问答和研究助手,不适合做排名监控,也不适合当爬虫的入口。
给老手:返回结构与存储期限
返回的 groundingMetadata 包含 webSearchQueries(模型执行的查询)、groundingChunks(来源网页)、groundingSupports(回答中每段文字对应哪个来源)和 searchEntryPoint.renderedContent(搜索建议的 HTML/CSS,必须原样渲染)。
定价页原文:Gemini 3“5,000 free search requests per month (shared across all Gemini 3 and newer models), then $14 per 1,000 requests”,默认“1,500 requests per day (RPD) per project”;Gemini 2.5 Pro“1,500 RPD (free), then $35 / 1,000 grounded prompts”。免费层(Free tier)不提供 Gemini 3 的 grounding。
Vertex AI(Agent Platform)上的免费额度和 Gemini API 不同,例如有资料列出 Gemini 2.5 Pro 每天 10,000 次。按你实际用的平台查价格页。
存储期限也分产品:Gemini API 附加条款允许在聊天记录等有限场景保存已经展示给用户的结果,Google 自己会保存 prompt 和输出 30 天用于生成和调试;Agent Platform 的零数据保留文档对 Google Search grounding 列的是最多 3 天日志。两者不能互相套用。
全网搜索方案:要申请,没有公开价格
Google 的公告和 API 文档都提到一个“全网搜索方案”(full web search solution),但只给了一个兴趣表。表上要填公司、Programmable Search Engine ID、网站、每日查询量和搜索需求。截至 2026 年 10 月 31 日,Google 没有公开这个方案的价格、配额、返回字段和服务协议,也没有公开的客户案例。
2026 年 9 月,Search Engine Journal 报道 Google 公开过一组只面向合作伙伴的 Web Search Service 文档:支持 REST 和 gRPC,每次请求要带合作协议对应的 client ID,最多返回 20 条结果。几周后这组文档被撤下,Google 没有解释原因。
所以,全网搜索方案目前只对 Google 选中的合作伙伴开放。 普通开发者可以填表,但不要把迁移计划押在它上面。
微软:Bing Search API 已下线,剩两个接口
很多人想到的第二个选择是 Bing。微软的 Bing Search API 已经在 2025 年 8 月 11 日退役,现有实例全部停用,也不再接受新客户。现在微软有两个替代接口。
| 接口 | 返回什么 | 价格 | 门槛 |
|---|---|---|---|
| Grounding with Bing Search | 模型的回答和引用,原始搜索结果不给开发者 | 每千次工具调用 14 美元 | 付费 Azure 订阅 |
Web IQ /web |
排好序的网页列表,带标题、网址、正文片段和抓取时间 | 每千次 7 美元 | 付费 Azure 订阅,访问要经微软审核 |
Grounding with Bing Search 和 Google 的 grounding 类似,在 Azure AI Foundry 的 Agent 里调用,你拿到的是模型写好的回答。微软的产品页写明,原始输出不能直接给其他程序使用。条款要求原样显示引用,不能用输出训练模型,也不能建立和 Bing 竞争的数据库。计费按工具调用次数算,一次 Agent 运行可能调用多次。
Web IQ 是微软 2026 年 6 月 2 日发布的新接口,直接返回网页列表和正文片段,不生成回答,你可以把结果交给任何模型。2026 年 10 月 16 日起,/web、/news、/images、/video 都是每千次 7 美元,抓取网页正文的 /browse 每千次 1 美元(要提工单开通)。默认每秒 15 次请求,Azure 的赠送额度不能用。
如果你原来用 Bing Search API 做 AI 应用的检索,Web IQ 是现在最接近的官方替代。但它的结果顺序是 Web IQ 自己的排序,和 Bing 搜索结果页上的位置无关。
给老手:Bing 退役日期的争议与 Web IQ 条款
微软生命周期公告(learn.microsoft.com/en-us/lifecycle/announcements/bing-search-api-retirement)写的是 2025-08-11 完全停用。WIRED 等媒体 2025 年 5 月报道过最大客户可能延后,微软没有公开确认过这种例外。
Grounding with Bing Search 和 Grounding with Bing Custom Search 都是“$14 per 1,000 transactions”,上限 150 TPS、每天 100 万次。没有公开的免费额度。
Web IQ 价格页标明所有端点都已 GA,价格 2026-10-16 生效;Auto 在 beta 期间不收费。产品条款同时写着访问“subject to review and approval”,所以 GA 不代表任何账号都能马上开通。条款要求在回答附近显示实际使用的来源,限制复制、缓存和建内容数据库。
Web IQ 的地区参数里有 CN,但这只说明支持中国地区的查询参数,不说明中国大陆网络能直连,也不说明 Azure 中国区能部署。
抓取 Google 结果页的 API:唯一能拿到排名的一类
做排名监控和 SERP 分析,只能用这一类。它们用代理和浏览器去请求 Google,把结果页解析成 JSON 返回。下表是五家常见服务截至 2026 年 10 月 31 日的公开价格:
| 服务 | 计费单位 | 每千个单位价格 | 免费额度 | 说明 |
|---|---|---|---|---|
| SerpApi | 成功的搜索 | 25 美元(入门档)到约 9.17 美元(大客户档) | 每月 250 次 | 字段最全,有 AI Overview、People Also Ask、本地商家包的专门接口 |
| Serper | credit(一般一次搜索 1 个) | 1 美元到 0.3 美元 | 一次性 2,500 次,不用绑卡 | 最便宜;credit 6 个月过期;完整字段文档没有公开 |
| DataForSEO | 结果页(每页 10 条) | 队列 0.6 美元 / 高优先 1.2 美元 / 实时 2 美元 | 1 美元试用金,最低充值 50 美元 | 余额不过期 |
| Bright Data | 成功的请求 | 1.5 美元 | 每月 5,000 次,不用绑卡 | 支持多个搜索引擎,可输出 JSON、HTML 和 Markdown |
| Oxylabs | 成功的结果 | 不渲染 JS 1 美元,渲染 JS 1.35 美元 | 2,000 次试用,不用绑卡 | AI Overview 字段没有找到公开的稳定保证 |
这些价格都是厂商自己的定价页,随时会调。但在实际工程落地中,下面三件事比标价更能决定你的真实成本与系统稳定性。
拿前 100 名要翻 10 页,且涉及代理会话粘性
2025 年 9 月,Google 对 Search Engine Land 确认,num=100 这个让单页显示 100 条结果的参数不再正式支持。此后一次请求基本只返回 10 条结果。
这意味着监控前 100 名的成本直接翻了 10 倍:按 DataForSEO 的价格,查 1,000 个词的前 100 名,队列模式要 6 美元,实时模式要 20 美元;如果只查前 10 名,成本仅为十分之一。更重要的是工程层面的代理一致性:多页翻页如果走随机轮询代理,第 1 页可能来自洛杉矶节点,第 2 页来自达拉斯节点,由于 Google 的本地化差异,翻页数据极易出现条目重复或遗漏。服务商必须支持并配置会话粘性代理(session-sticky proxy)。在实际业务中,建议给监控词分级:核心高转化词追踪前 50 到 100 名,长尾词仅监控前 10 到 20 名。
每次看到的都是一张带动态特征的快照
抓取 API 返回的位置,是在指定地理坐标(UULE)、语言、设备和时间戳下的单次快照。Google 不仅长期进行高频的 SERP 版面实验,其反爬机制 SearchGuard 还会动态下发 JavaScript 混淆质询和环境探测。抓取服务通常需要维护庞大的住宅代理池与无头浏览器集群来应对,这也是为什么各家抓取 API 的响应延迟通常在 800 ms 到 3 秒之间波动。
此外,AI Overview 和本地商家包占据了大量首屏空间。即使抓取 API 判定某个 URL 为“自然排名第 3 位”,在用户的实际屏幕上它可能已经被挤出了前两屏。监控时不仅要看绝对排名,还要看该关键词是否触发了 SERP 交互组件。
Google 起诉了 SerpApi:技术保护与公开数据的边界
2025 年 12 月 19 日,Google 在加州北区联邦地区法院起诉 SerpApi(案号 4:25-cv-10826-YGR)。Google 主张 SerpApi 绕过了其反爬系统 SearchGuard,违反了美国《数字千年版权法》(DMCA)第 1201 条关于禁止规避技术保护措施的规定。按诉状说明,SearchGuard 自 2025 年 1 月起通过动态 JS 质询拦截自动化请求。
2026 年 7 月 20 日,法院对 SerpApi 的驳回动议作出关键裁决:
- 对于不含受版权保护内容的搜索结果,DMCA 反规避条款不适用。这部分裁定为不予允许修改(without leave to amend)。这确立了一个重要逻辑:公开的事实性搜索数据(如链接、标题、文本摘要)不受版权法保护,单纯绕过反爬机制抓取公开事实不构成 DMCA 侵权。
- 对于包含受版权保护组件的部分(例如知识面板中的第三方授权图片),Google 因未说明版权人授权其部署 SearchGuard 保护该内容而被驳回,但允许 Google 修改诉状。
Google 于 8 月 10 日递交了修改后的诉状,将侵权主张收窄至受保护的授权内容;SerpApi 在 8 月 24 日再次申请驳回。截至 10 月 31 日,第二轮动议仍在审理中。
这一裁定守住了抓取公开事实数据的防线,但并不代表抓取 SERP 完全没有合规风险。 Google 仍可能通过修改后的诉状、服务条款(ToS)违约或技术封堵持续施压。从系统架构设计的角度来看,业务代码绝不能与某一家抓取 API 的专有 SDK 强绑定。务必在中间层实现标准化适配器(对统一的入参和出参做映射),一旦某家供应商遭遇法务禁令或反爬拦截率飙升,可以通过环境变量在几分钟内无缝切换至备选供应商。
给老手:裁定细节与案卷
2026-07-20 的裁定(FindLaw 有全文):涉及不可版权内容的部分“without leave to amend”;涉及可版权组件的部分“with leave to amend”,缺陷在于 Google 没有充分主张 SearchGuard 是“经版权人授权”部署的技术措施。法院同时认为,Google 已经主张了足够的事实,可以推断 SerpApi 规避了 SearchGuard;也驳回了 SerpApi 关于 Google 不具备 DMCA 诉讼资格的抗辩。所以 SerpApi 的新闻稿说“胜诉”只说对了一部分。
后续案卷:Dkt. 45 修改后的诉状(08-10);Dkt. 49 SerpApi 再次申请驳回(08-24);Dkt. 57 驳回 SerpApi 要求 Google 提交许可协议的动议(09-15);Dkt. 58 Google 答辩(09-15);Dkt. 59 SerpApi 回复(09-29);10-05 取消 10-13 的听证。公开索引里还有一条 10-13 的 Dkt. 61“Statement of Recent Decision”,内容没有公开,不能据此判断结果。
Google 起诉状 PDF 的页眉有一处写成 5:25-cv-10826,以法院案卷的 4:25-cv-10826-YGR 为准。
关于 num=100:Google 发言人原话是“The use of this URL parameter is not something that we formally support.”Google 没有说取消它是为了反爬,这只是行业的推测。
新时代面向 AI 的搜索 API:Tavily、DeepSeek 与 Exa
如果你开发的是 AI Agent、知识库 RAG 或程序化调研工具,并不需要 Google 的特定自然排位,那么在 Custom Search JSON API 停服后,最值得接入的并不是传统的 SERP 抓取接口,而是这批专为大模型设计的新一代搜索 API。
从“给人看蓝链”到“给模型喂正文”
传统搜索引擎(如 Google CSE、Bing Web Search)是为人眼点击设计的,返回的只有三样东西:title(标题)、url(网址)和一段 100 到 150 字的 snippet(标红关键词摘要)。
在大模型问答场景下,150 字的摘要根本不够提供充分的事实支撑。如果让 Agent 拿着网址自己去发 HTTP 请求抓网页,就会遭遇三大痛点:
- 反爬拦截:目标站点经常部署 Cloudflare 质询、验证码或防盗链,爬虫容易抛出 403/503;
- 正文提取繁琐:网页里塞满了导航栏、页脚广告和 JavaScript 脚本,需要自建 Trafilatura / Readability 清洗流水线;
- 延迟与 Token 膨胀:二次抓取不仅增加 2 到 5 秒延迟,未清洗的网页 HTML 动辄占用上万 Token,导致模型的推理开销暴增。
新一代面向 AI 的搜索 API(Tavily、DeepSeek、Exa 等)直接把“全网检索 + 网页抓取 + 正文清洗 + 向量重排”封装成了一次 API 调用:输入查询词,直接返回清洗好的 Markdown 正文片段或直接答案。
| 服务 | 检索范式与索引来源 | 价格(每千次) | 免费额度 | 核心特色 |
|---|---|---|---|---|
| DeepSeek Search API | 自建独立索引,支持向量与两阶段重排 | 0.75 美元(5 元) | 接口按调用计费;Harness/Codex 调用有免费期 | 极低成本;直接返回约千字正文摘要与 rerank_score |
| Tavily | 专为 Agent 优化的检索栈,必要时调用第三方 | 8 美元(每 credit 0.008 美元) | 每月 1,000 credit,无需绑卡 | 开箱即用清洗好的 Markdown 上下文;与主流 Agent 框架原生集成 |
| Exa | 纯向量语义检索(Neural Search),自建索引 | 4 / 7 / 12 美元(Lite / Auto / Deep) | 每月 10 美元 + 10 美元奖励,无需绑卡 | 擅长语义模糊查询与相似网页发现;支持提取 highlights |
| Brave Search API | 自建独立全网索引(BraveBot),非转售 | 5 美元 | 每月 5 美元(约 1,000 次),需绑卡 | 欧美少有的纯独立通用大索引;数据主权与隐私清晰 |
| Perplexity Search API | 专有网页索引与数据源聚合 | 标准 5 美元,Fast 1 美元 | 无公开免费额度 | 强调新鲜度与快速召回,纯检索不生成回答 |
| You.com | 自建网页与新闻索引 | 5 美元 | 10 美元额度(约 2,000 次) | 支持正文提取;提供免费 MCP 端点 |
| Parallel | 自建索引,压缩抽取 | 1 美元 / 5 美元 | 每月最多 5,000 次,部分需绑卡 | 专注于为 LLM 输出高压缩比的事实片段 |
Tavily:专为 Agent 与 RAG 设计的检索聚合器
Tavily 是目前在 LangChain、LlamaIndex 和各类 AI Coding Agent 中被集成最多的检索服务之一。它的定位不是给普通人使用的搜索引擎,而是专门为大模型提供“RAG-ready”上下文的中间件。
- 开箱即用的上下文提取:调用 Tavily 时,它不仅返回网页链接,还会自动抓取网页核心内容并剔除噪音,输出干净的 Markdown 文本片段;
- 智能重排与直接答案:提供
include_answer等参数,可以直接生成一段简明事实回答与各来源的可信度得分; - 计费与限制:按 credit 计费(基础搜索 1 credit,高级深度搜索消耗更多)。新用户每月有 1,000 credits 免费额度,且不需要绑定信用卡。
需要留意的工程细节是隐私与数据源政策:Tavily 官方隐私政策注明,当其自有索引和缓存无法覆盖用户的长尾查询时,可能会将查询共享给包括 Google 在内的第三方搜索提供商。如果你的查询内容涉及商业机密或严格合规要求,需要核对该条款。
DeepSeek Search API:极低成本与两阶段重排的透明度
DeepSeek 随着模型更新开放的 Search 与 Fetch API,在开发者圈内引发了巨大关注。它最大的两个优势是极低的使用成本和高度透明的两阶段排序机制。
- 价格击穿行业底线:定价仅为每千次成功请求 5 元人民币(约 0.75 美元),只有返回 200 且结果非空时才计费,成本仅为传统搜索 API 或 Exa/Tavily 的十分之一到百分之一;
- 直接附带高质量长摘要:单条结果通常附带长达数百甚至上千字的内容切片,开发者无需二次调用爬虫抓取正文;
- 暴露召回与重排打分:传统搜索引擎把排序当黑盒,而 DeepSeek Search API 在返回 JSON 中直接公开了召回层的静态标签
authority(0 到 4 级的站点权威分,基于 host 评定)以及重排层的连续打分rerank_score(0 到 3 分)。返回列表严格按rerank_score降序排列; - 实测性能特征:根据我对 378 个查询的实测,DeepSeek 具有极强的时效性偏向(时效类查询 59% 结果在 7 天以内发布),在技术文档、代码排错、中文语料和电商商品查询上表现极佳;但在西方社区(如 Reddit、YouTube、Medium)以及强导航类品牌官网查询上,召回率弱于传统 Google/Bing 搜索。
对于需要频繁执行网络搜索的 AI 编程 Agent 或多语言知识库,DeepSeek 是目前综合成本最低的高性能方案。
Exa:纯向量语义检索(Neural Search)
Exa 采用了与传统倒排索引(BM25 词频匹配)截然不同的检索路线:它将网页内容转换为高维语义向量,直接通过向量相似度来检索网页。
- 语义联想能力强:即使你输入的查询词没有精准命中目标网页的字面文字,只要语义逻辑相关,Exa 也能精准召回;
- 链接与相似发现:提供
find_similar功能,输入一个优质参考链接,直接召回全网风格和主题最相近的其他网页; - 适用边界:适合学术研究、竞品调研、技术趋势追踪;但对于特定的精确报错代码、函数名、或者强导航型官方网址,纯向量检索的字面精准度有时不如带传统倒排索引的引擎。
技术选型建议
在为 AI 应用与 Agent 选择新时代搜索 API 时,建议按以下逻辑决策:
- 如果是 Agent 编程辅助与高频 RAG 知识库:首选 DeepSeek Search API(成本极低、带千字摘要)或 Tavily(成熟的框架生态、清洗后的 Markdown 开箱即用);
- 如果是深度市场调研与相似竞品挖掘:选择 Exa,利用其语义向量与网页相似度能力;
- 如果对数据主权、隐私和独立索引有严格要求:选择 Brave Search API,确保检索结果不经过任何第三方上游分发。
给老手:公开的对比测试
- Parallel 用 SimpleQA Verified 抽 100 题测了自家和 Exa、Tavily、Perplexity,LLM 评分,成本含模型 token。厂商自测,而且 Exa、Tavily 可以用正文提取工具,Perplexity 只用搜索,条件不完全对等。
- OpenBenchmarks Labs 的 Web Search for Coding Agents:固定模型、公开代码和数据集,100 个开发文档类任务跑 3 次。搜索加抓取那一轨 Exa deep 领先,只搜索那一轨 Perplexity 较好。任务只覆盖开发文档。
- SearchPipe 在 2026-10-24 用 300 题 SimpleQA Verified 测了多家,给了 95% 置信区间和每题结果。SearchPipe 自己也参赛,不完全中立。
- Artificial Analysis 公开了 Search API 的测试方法(固定
max_results=10,过滤测试集污染),适合比较召回和证据质量。
这些测试都回答不了“某个网址在 Google 第几名”。
Brave 的价格页另有 Answers 接口,每千次 4 美元再加 token 费;存储搜索结果需要有存储权的套餐。Exa 的 Agent 按运行次数和档位计费。
国内开发者要多看两件事
对在国内的开发者,选型之前还要确认两件事:能不能付款,能不能搜到英文网页。
付款。 能确认的情况如下:Brave 激活任何套餐都要绑信用卡;Exa 和 Tavily 的免费档不用绑卡;Web IQ 和 Grounding with Bing 要付费的 Azure 订阅,赠送额度不能用;Parallel 的免费额度部分情况要绑卡。各家是否接受国内发行的卡、从中国大陆网络能否直连,官方都没有统一说明,要自己试。
国产搜索接口。 如果你的应用主要服务国内用户,或者海外接口付款困难,可以看看这几家:
| 接口 | 价格(每千次) | 说明 |
|---|---|---|
| 博查 Web Search / AI Search | 约 36 元 / 60 元 | 这是 2025 年 5 月的公开价格文件,2026 年价格没有找到公开更新;官方说支持中英文和多种语言 |
| 秘塔 AI 搜索 API | 没有公开统一价格 | 有搜索、网页读取和问答接口;用户协议禁止系统性提取数据建库 |
| 智谱 Web Search | 媒体报道 Std 10 元、Pro 30 元 | 官方价格页没有核到同样的数字 |
Kimi web_search |
官方 0.03 元 / 次,即 30 元 | 官方排错页提示这个功能正在升级、旧文档已过时;媒体报道过另一组价格 |
| 百度千帆 AI 搜索 | 活动价 4.9 元 / 9.9 元,原价 40 元 / 72 元 | 活动到 2026-12-31;没有找到英文网页覆盖的公开说明 |
这几家都不返回 Google 的排名。做外贸独立站相关的英文应用,先拿一组英文查询实测召回率,看能否搜到英文官网、新闻和论坛,再决定用不用。
迁移前的检查表
如果你现在还在用 Custom Search JSON API,建议按这个顺序准备:
- 在 Google Cloud 控制台导出过去 90 天的调用量、错误码和主要查询。
- 把查询分成三类:站内搜索、固定网站范围的搜索、全网搜索。三类分别找替代方案,不要硬塞进同一个接口。
- 再把“全网搜索”分成两类:要 Google 排名的,和只要相关网页的。前者选抓取类 API,后者选 grounding 或独立索引。
- 在代码里加一层适配,把供应商、参数和返回字段的映射放进配置。以后换供应商只改这一层。
- 为结果字段写快照测试,至少覆盖标题、链接、摘要为空的情况。
- 用真实查询在两到三家候选上跑一遍,比较结果质量和实际成本,再定主备供应商。
- 2026 年 12 月中旬之前完成切换和灰度,不要等到 2027 年 1 月 1 日当天。
对你意味着什么
按你手上的任务对照:
- 只是给网站加搜索框:用 Programmable Search Element,免费,接受广告就行。
- 做排名监控、SERP 功能分析:只能用抓取类 API。按计费单位和查询深度算成本,选两家互为备份,并关注 Google 起诉 SerpApi 一案的进展。
- 做 AI 应用、Agent 联网或 RAG:不需要 Google 排名。已经在用 Gemini 的,可以直接开 Grounding with Google Search,注意 Gemini 3 按搜索次数计费;想要模型无关的结果列表,看 Web IQ、Brave、Exa、Tavily 等,用自己的查询实测后再选。
- 搜索固定的几十个网站:Agent Search Enterprise 版,每千次 4 美元,有每月 10,000 次免费试用。
- 确实需要 Google 全网结果,又不能用抓取服务:填 Google 的兴趣表,同时准备好备选方案,因为什么时候有回复、价格多少都不确定。
附录:证据清单
| 判断 | 来源类型 | 出处 |
|---|---|---|
| Custom Search JSON API 不接受新客户,2027-01-01 停服;现有客户每天免费 100 次,每千次 5 美元,每天最多 10,000 次 | 官方文档 | Custom Search JSON API 概览(2026-02-18 更新) |
| 新引擎只能用“Sites to search”(最多 50 个域名);旧的全网选项保留到 2027-01-01;全网需求填兴趣表 | 官方公告 | Programmable Search Engine 博客,2026-01-20 |
| 关闭全网选项后无法重开 | 社区答复 | Programmable Search Engine 社区 |
| Search Element 标准版免费带广告;Paid Element 不接受新客户 | 官方文档 | 产品对比、广告说明 |
| Agent Search 价格:Standard 1.5 美元、Enterprise 4 美元、生成式答案高级版加 4 美元;每月 10,000 次免费试用 | 官方价格页 | Agent Search pricing |
| Agent Search 迁移步骤;基础网站索引 50 条网址规则,高级 500 条 | 官方文档 | 从 CSE 迁移、准备数据 |
| Gemini 3 grounding 按搜索次数计费,每月 5,000 次免费后每千次 14 美元;Gemini 2.5 按 prompt 每千次 35 美元 | 官方价格页 | Gemini API pricing、Grounding with Google Search |
| Grounding 必须显示搜索建议,不得缓存、训练、建索引 | 官方条款 | Google Cloud Service Specific Terms |
| Google 曾公开、后撤下面向合作伙伴的 Web Search Service 文档 | 媒体报道 | Search Engine Journal、Search Engine Roundtable |
| Bing Search API 于 2025-08-11 退役 | 官方公告 | Microsoft Lifecycle |
| Grounding with Bing Search 每千次 14 美元,150 TPS,每天 100 万次 | 官方价格页 | Bing APIs |
| Web IQ 各端点价格,2026-10-16 生效;要付费 Azure,访问需审核 | 官方文档 | Web IQ pricing、Web IQ 概览、发布公告 |
| SerpApi、Serper、DataForSEO、Bright Data、Oxylabs 的价格和免费额度 | 厂商定价页 | SerpApi、Serper、DataForSEO、Bright Data、Oxylabs |
Google 不正式支持 num=100 |
媒体报道(Google 发言人表态) | Search Engine Land |
| Google v. SerpApi:2025-12-19 起诉;2026-07-20 部分驳回;08-10 修改诉状;截至 10-31 第二轮动议未裁定 | 法院文件 | 2026-07-20 裁定、CourtListener 案卷 |
| Brave、Exa、Tavily、Perplexity、You.com、Parallel 的价格、免费额度和索引说明 | 厂商定价页与文档 | Brave、Exa、Tavily、Tavily 隐私政策、Perplexity、You.com、Parallel |
| 公开的搜索 API 对比测试 | 厂商自测与第三方测试 | Parallel、OpenBenchmarks Labs、SearchPipe、Artificial Analysis |
| 国产搜索接口价格 | 官方页面、价格文件与媒体报道 | 博查、秘塔、Kimi 价格、百度千帆活动价、智谱价格报道 |
| DeepSeek 与 Google 结果网址 Jaccard 0.006,前 5 条相关性打平 | 本人实测 | 378 个查询,报告待发布 |
谷歌搜索 API 平替:停服后怎么获取 Google 搜索结果