我在翼果 SEO × GEO 技术大会分享了什么:让内容既能排名,也能被引用


2026 年 8 月 12 日,我们在深圳办了 2026 谷歌 SEO × 海外 GEO 技术大会。我在会上讲了 45 分钟的《一份内容,两处收割:既上 Google 排名,又被 AI 引用》。当时有 300 多位独立站卖家和内容团队负责人在场,会后不少人来问同一个问题:现在用 AI 写一篇 2,000 字的博客只要几分钟,内容团队到底该把时间花在哪里,才能让同一套内容既排进 Google 前列,又能进入 ChatGPT、Perplexity 和 Google AI Overviews 的回答?
这篇文章把我在现场讲的那套 30 页课件完整摊开。我不打算给一份“AI 喜欢的文章格式”,而是按我们团队日常交付的顺序,把需求怎么拆、证据怎么补、几十个页面怎么对表、上线前怎么验收、不同岗位怎么拿同一套材料干活,原原本本讲清楚。
Linus Li,常驻深圳。翼果科技技术解决方案部主管,负责筋斗云 SEO 的技术 SEO、GEO 与 Shopify 方向。
GEO 是生成式引擎优化(Generative Engine Optimization),本文用它指围绕 AI 搜索回答开展的内容与可见性工作。如果你是第一次系统梳理这块工作,可以先配合我在筋斗云 SEO 写的 GEO 完整指南(2026 版) 和 SEO 内容策略完整指南 一起看;如果你关心大会当天 Google、Semrush、亚马逊嘉宾和另外四位同事讲了什么,可以直接看公司官网的大会全景回顾。
要点
- 页面排名和事实引用是两套测试:SEO 的竞争单位是 URL,解决页面能不能进入候选集;GEO 的选择单位是具体主张、事实和证据,解决页面里的哪句话能进入最终答案。
- 决策型问题最先被 AI 接管:越靠近比较、选型和适用场景的问题,越容易触发生成式回答。被 AI 引用不会把流量原样还给你,但不被引用会让点击再少掉一半以上。
- 用“删除测试”检查信息增益:把品牌名和套话删掉,如果只剩通用定义和行业常识,这篇内容随时会被模型和同行替代;如果还剩实测数据、失败案例、工程师判断和适用边界,才有独立存在的价值。
- 一个集群里最贵的不是写字,是让几十个页面长期说同一件事:用一张八字段事实表管理全站主张,允许不同渠道语气不同,不允许结论和边界漂移。
- 交付物从“一篇文章”升级为“一套主题包”:围绕核心主题同时交付事实表、页面地图、写作蓝本、可复用证据模块和渠道使用卡,让 SEO、编辑、视频、社媒、销售和客服从同一张表取数。
为什么有排名,却不一定有 AI 引用
备课那两个月,我看了很多出海品牌的 Search Console 和 AI 抽样报告。最常见的一种困惑是:某个核心词明明排在 Google 自然结果前三名,但去问 ChatGPT、Perplexity,或者看 Google 自己的 AI Overviews,里面根本不提这个品牌,或者引用的全是别人家的评测和论坛帖子。
我把原因放在了分享的第一部分:同一篇内容,现在要同时通过“页面竞争”和“事实选择”两套测试。
过去做 SEO,我们的竞争单位是页面(Page / URL)。搜索引擎主要看三件事:这个页面适不适合解决当前查询、和同类页面相比应该排在第几、用户值不值得点进来继续行动。只要页面的主题覆盖完整、权重够、加载和内链没问题,它就能拿到一个好位置。
到了 AI 搜索里,生成答案的选择单位变成了具体的主张、事实和证据(Claim / Fact / Evidence)。系统把一个问题拆开后,会继续追问四件事:
- 页面里的哪条事实正好回答了当前的子问题?
- 这个结论有没有足够的证据和成立边界?
- 全网有哪些独立来源可以共同支撑这个说法?
- 最终生成的答案,有没有真正采用你的事实和数据?
所以,SEO 主要解决页面能不能进入候选集并赢得位置,GEO 则进一步关注页面里的哪些事实最终进入了答案。它们不是完全割裂的两套内容,但也不是同一场考试。
我在现场放了两组行业研究数据,帮大家看清为什么要盯紧这件事:
第一组来自 Seer Interactive 2026 年更新的《AIO Impact on Google CTR》(覆盖 53 个品牌、547 万条查询)。按查询意图拆开看,生成式答案的出现率极不均匀:信息型查询占 88%,商业调研型占 76%,比较型占 66%,本地型占 38%,而纯交易型查询只有 12%。也就是说,用户在搜“buy X”准备直接下单时,还是会自己点进商品页;但越接近比较、选型和“哪个更适合我”这类购买前最关键的决策问题,几乎都会先被 AI 回答一遍。
第二组是 Ahrefs 和 Seer Interactive 对引用与点击的交叉测量。Ahrefs 在 2025 年 7 月测得 AI Overviews 引用页面同时排在自然前十的比例是 76%,到 2026 年最新测量(读取全部引用 URL)时,这个比例降到了 38%,即约 62%~63% 的被引用 URL 并不在直接查询的自然前十名里。同时,Seer 的数据显示,在没有 AI Overviews 时自然点击率约为 3.82%;出现 AI Overviews 但你的页面没被引用时,点击率掉到 0.94%~1.3%;而如果你出现在 AI Overviews 的引用里,点击率能保持在 2.36%~2.4% 左右,比没被引用高出约 120%。
排名仍然重要,但它已经不能单独解释“谁会被引用”;在有 AI 回答的场景里,被引用不会把流量原样还给你,但能让你比“没被引用”少损失一半以上。 内容必须在被引用的那一刻就把关键事实和适用条件讲清楚,不能再抱着“先把用户骗点进来再说”的心态写水文。
在推进内容改造之前,Google 官方要求的技术底线依然要守住。我在课件第 5 页把整个过程排成五步:
- 技术资格:能被抓取、能被索引、Canonical 指向清楚。
- 需求匹配:搜索意图、页面类型与主题边界一致。
- 候选与排名:通过核心排名与质量系统进入候选集。
- 事实选择:定义、数字、比较和步骤能被独立提取。
- 答案与行动:形成引用、答案吸收、点击与业务转化。
前三步是 SEO 地基,第四步和第五步是 GEO 额外要解决的问题。Google Search Central 在 2026 年 7 月更新的 AI 功能指南写得很明确:页面必须先被索引并有资格在搜索结果中展示摘要,才有机会作为 AI Overviews 或 AI Mode 的支持链接。如果你不确定自己的页面能不能被主流 AI 爬虫顺利读取,可以先用站内的 AI 爬虫 robots.txt 检测工具 和 AI 爬虫视角查看器 扫一遍。
从关键词扩展到用户的问题网络
为什么约 63% 的被引用页面不在直接查询的自然前十?因为 Google 在生成回答时使用了 扇出查询(Query Fan-out)机制:系统会把用户的原始提问拆成一串相关的子问题,分别向不同子主题和数据源发起检索,再把找回来的碎片合成最终答案。
这就要求我们把内容规划的单位,从单个“主关键词”换成“问题簇 + 子问题 + 决策过程”。
我在现场没有拿枯燥的软件词举例,而是用了一个独立站卖家一听就懂的场景:“有宠物、南方高温、每天使用的家庭影院,应该选哪种座椅材料?”
用户表面上只问了一句话,但他要完成的是一整串购买判断。如果编辑只对着关键词写一篇《真皮与科技布优缺点对比》,大概率抓不到重点。拆成问题网络之后,内容团队真正需要回答的是六个具体子问题:
| 用户实际关心的事 | 用户脑子里的具体问题 | 内容与产品团队需要准备的事实 |
|---|---|---|
| 耐刮 | 猫狗抓挠会不会一下就破? | 材料表面的抗刮测试数据、涂层厚度与使用限制 |
| 清洁 | 洒了饮料或粘毛好不好打理? | 常见污渍的处理步骤,以及哪些化学清洁剂会腐蚀表面 |
| 体感 | 南方夏天不开空调坐上去闷不闷? | 不同材质的透气性与接触温感,室温与湿度怎样影响选择 |
| 耐久 | 每天坐两三个小时,哪里最容易坏? | 接缝、海绵回弹与摩擦部位的寿命判断依据及测试条件 |
| 风险 | 哪类家庭其实不该买这种材质? | 明确写出不适用人群,而不是宣传“所有家庭都适合” |
| 质保 | 被宠物抓坏或脱皮算不算质保? | 质保覆盖范围、免责条款与售后处理流程 |
怎么把这张问题网络找全?我在团队里要求必须把“三股需求”汇到一起,才能决定一个页面该干什么:
- 第一股是搜索需求:看关键词搜索量、SERP 页面类型、People Also Ask 和 Search Console 里的真实查询。关键词不是文章标题生成器,它是需求确实存在的证据。
- 第二股是 AI 提问需求:看用户在对话式搜索里怎么带场景提问、子问题怎么展开、下一轮会追问什么。
- 第三股是业务真实需求:去翻销售异议记录、客服工单、差评和退货原因,看用户在掏钱前最后一刻卡在哪个顾虑上。
三股需求汇合后,下一步是定页面职责。拆出六个子问题,绝不意味着要新建六个薄页面。我们在立项时会连问四句:这个需求该由产品页、集合页、博客、对比页还是工具页承担?这个页面有没有一个清晰的主任务?站内是不是已经有另一个页面在抢同一个需求?用户看完之后应该点进哪个商业页面?能在同一页讲透的,就集中精力把现有页面做厚;只有具备独立需求、新增事实和清晰下一步行动的问题,才值得单独建 URL。
内容矩阵、主题集群与证据网:把站内站外拉进同一张表
很多团队做内容扩张,停留在“多写几篇”的阶段。我在课件第 8 页把内容组织方式分成了三次进阶:内容矩阵 → 支柱页与集群(Hub & Spoke) → 证据网(Evidence Network)。 这三步是叠加关系,不是替代关系。
| 组织阶段 | 具体做法 | 解决什么问题 | 容易卡在哪里 |
|---|---|---|---|
| 01 内容矩阵(Content Matrix) | 按“关键词 × 页面类型”列表格,模板化批量生产,一词对应一页 | 解决基础覆盖率,短期内快速铺开长尾词卡位 | 结构平铺,极易演变成换几个词就发一篇的近似薄页 |
| 02 支柱页与集群(Hub & Spoke) | 用一个核心总览页(Hub)汇总全局,通过内链连接多个深入解释子问题的子页(Spoke) | 解决信息结构,帮搜索引擎和用户理解主题层次(详见话题权威构建指南) | 只画了树状目录,但子页面里全是行业套话,缺少可核查的事实 |
| 03 证据网(Evidence Network) | 把核心主张、事实证据与权威来源通过交叉链接连成可验证的网络 | 解决可信度与一致性,让 AI 检索模型能直接采信、归因并引用 | 站内各页面数字打架,或者站外第三方说的和官网对不上 |
为什么不能只停在站内集群,必须往前走到“证据网”?因为在很多行业里,品牌事实的主要载体并不只在官网,第三方来源正在直接参与定义你。
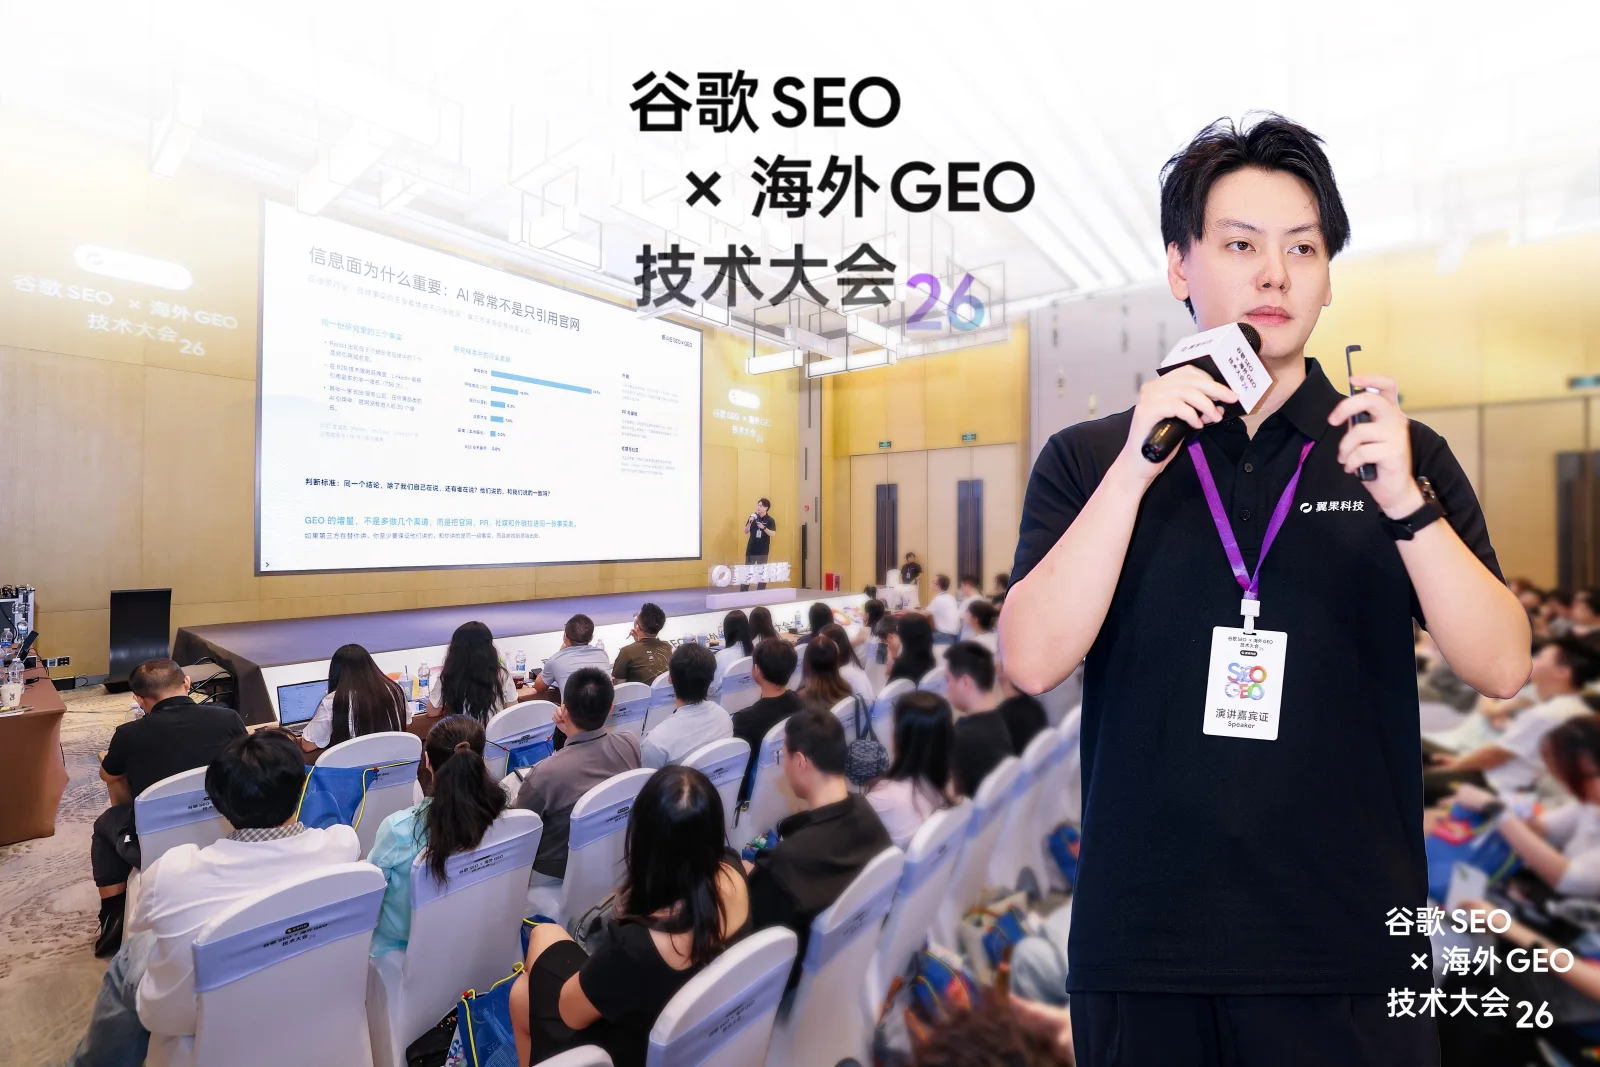
图:我在现场展示第 9 页课件《信息面为什么重要:AI 常常不是只引用官网》。
我在现场展示了一份多行业 AI 引用研究(见上图背景屏幕):
- 在被研究的 8 个品牌里,有 7 个品牌的高频引用域名里出现了 Reddit(关于 Reddit 在 AI 搜索里的机制与反垃圾规则,可以看我另一篇《Reddit 每天拦截 2300 万次垃圾曝光》)。
- 在 B2B 技术服务品牌里,LinkedIn 是被引用最多的单一域名(736 次);其中一家 B2B 服务公司在所属品类的 AI 引用中,自家官网甚至没有进入前 30 个域名。
- UGC 类域名(Reddit、YouTube、LinkedIn)的平均引用效率达到 1.16 次/每次搜索。
- 不同行业的官网依赖度差异极大:高等教育接近 74.7%,特色食品 CPG 占 18.9%,医疗非营利占 8.3%,消费汽车占 7.4%,本地医美服务占 3.0%,而样本里的 B2B 技术服务官网占比低至 0.0%。
这组数据逼着我们重新理解站外渠道的作用:
- 外链:过去主要是传递权重;现在它多了一层作用,是一条可校验的引用路径,机器会顺着它确认你的说法有没有第三方支撑。
- PR 与媒体:过去图的是曝光;现在是把品牌的数据和测试方法放进一个独立的第三方来源里。一个能被行业媒体转述的实测数字,比官网写十篇自夸文章更容易进入 AI 答案。
- 社媒与社区:过去用来搞流量;现在是真实问题来源和使用体验的证据库。Reddit、YouTube 和 LinkedIn 频繁出现在引用列表里,是因为它们提供了官网给不了的真实使用反馈。
所以我在现场反复强调:GEO 新增加的工作,不是多开几个社媒账号或多发几篇外链软文,而是把官网、PR、社媒、评测和外链拉进同一张事实表。 官网负责做最稳定的事实源;如果第三方在替你讲,你至少要保证他们引用的是你最新确认过的同一组事实,而且顺着链接能找回官网的原始出处。
为了把整个集群拉起来,我们还会在每个重要主题集群里专门设计一两篇“引力中心”内容。它的判断标准只有一句:这一篇有没有让别人愿意主动引用我们,而不是我们去引用别人?一篇合格的引力中心内容,至少要具备以下五样中的一样:
- 一个别人没有的实测或统计数据;
- 一个写清条件、可复现的测试方法;
- 一个可直接引用的清晰定义或行业基准;
- 一张能被同行或媒体直接截图转发的对比图表;
- 一个 PR 团队能直接拿去发稿的核心结论。
有了这篇引力中心,外部外链自然落在它身上,社媒的场景切口从它出,PR 的数据故事从它出,站内其他子页面链回它,销售和客服也能直接拿它发给客户。
信息增益:用一个简单的“删除测试”筛掉套话
既然证据这么重要,日常审稿时怎么快速判断一篇文章有没有提供新东西?我在课件第 12 页给了团队一个最简单的操作办法:删除测试。
拿到一篇初稿,先把你们品牌的名称、产品型号和自我表扬的形容词全部删掉,看看文章里还剩下什么:
- 如果删完只剩下:通用定义、通用操作步骤、谁都能背出来的行业常识。那这篇内容只能承担基础的搜索覆盖任务,AI 30 秒就能生成一篇一模一样的,竞争对手也能随便抄走,绝不能把它包装成核心差异化内容。
- 如果删完还剩下:具体条件下的真实测试结果、客户实际使用过程、踩过的失败案例、产品工程师的取舍判断、销售在跟单中反复遇到的误区,以及不同条件下结果为什么会变化的边界说明。从这里开始,内容才真正具备了信息增益(Information Gain)和不可替代性。
这和 Google 搜索联络人 Danny Sullivan 在 2026 年 4 月提出、并在 7 月写进官方指南的“非商品化内容(Non-commodity content)”完全一致:内容必须提供独特(Unique)、具体(Specific)和真实经验(Real experience)。
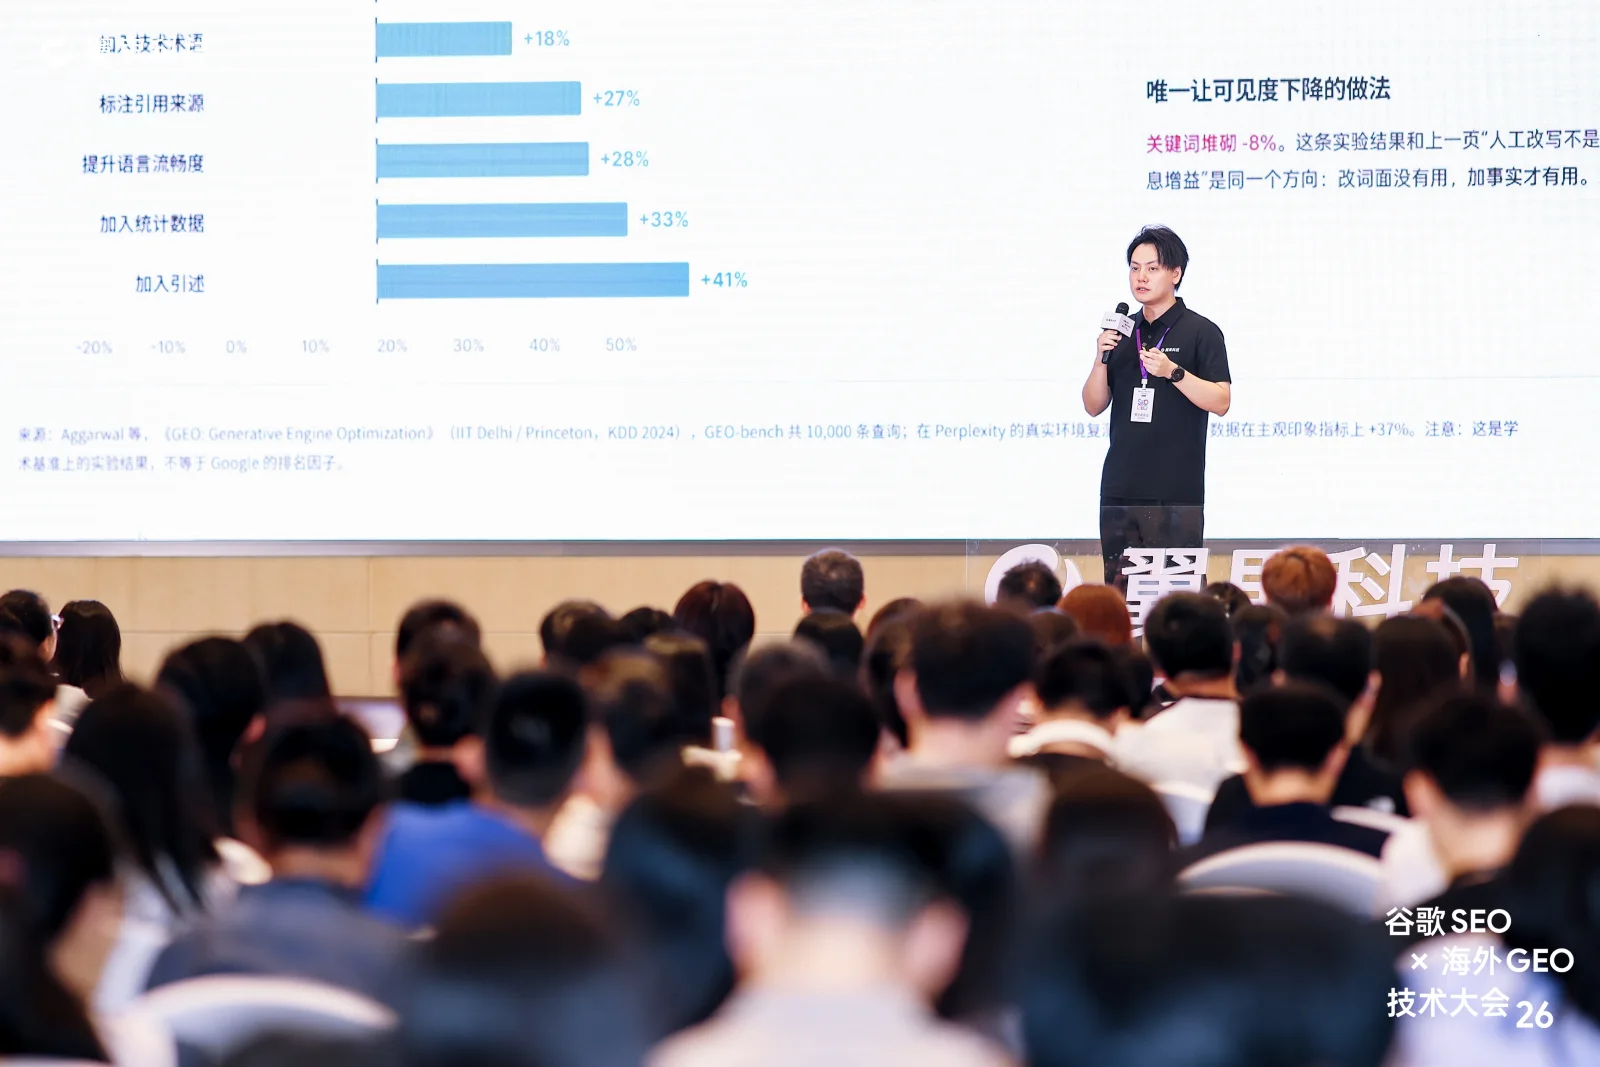
图:我在现场讲解学术基准实验数据:改词面和堆砌关键词没用,加统计数据、引述和来源才有用。
我在现场还专门放了一页 IIT Delhi 与 Princeton 大学发表在 KDD 2024 上的《GEO: Generative Engine Optimization》论文实验数据(见上图)。在 10,000 条查询的 GEO-bench 基准测试以及 Perplexity 真实环境复测中:
- 加入具体引述(Quotation Addition)让可见度提升了 **+41%**;
- 加入统计数据(Statistics Addition)提升了 **+33%**;
- 提升语言流畅度(Fluency Optimization)提升了 **+28%**;
- 标注引用来源(Cite Sources)提升了 **+27%**;
- 加入准确的技术术语(Technical Terms)提升了 **+18%**;
- 唯一让可见度下降的做法,是传统 SEO 爱干的“关键词堆砌(Keyword Stuffing)”,直接下降了 -8%。
我在幻灯片底部特别加了一行小字提醒:这是学术基准上的受控实验结果,不等于 Google 的真实排名因子。但它和前面讲的“人工改写同义词不算信息增益”指向同一个方向:只改词面没有用,往页面里加可验证的事实、数字和来源才有用。 你也可以用我们站内的 AI 可引用性检查工具,快速检查页面里缺不缺这类可直接提取的定义、数字和对比块。
同时,我也给团队泼了一盆冷水:非商品化内容不是一个自动排名的开关。 一篇内容不会因为“足够原创”就自动排上去,也不会因为塞了一段第一方经验就自动被 AI 引用。我们用一张“需求 × 证据”四象限表来做选题门禁:
| 需求与证据组合 | 属于什么状态 | 处理方式 |
|---|---|---|
| 有真实需求 + 有独创证据 | 核心内容:页面类型正确、检索相关,且答案里有别人没有的事实 | 重点投入,唯一有机会同时拿到排名、AI 引用和用户信任的象限 |
| 有真实需求 + 没有独创证据 | 平均答案:写得正确、全面,但 AI 能写,竞争对手也能写 | 先补产品实测、工程判断或客户案例,没补齐前不按重点稿排产 |
| 没有真实需求 + 有独创证据 | 企业自嗨:测试很独特,但没人搜索,也没人这样问 | 重新调整切入角度,把它挂载到用户真正在做的购买决定下面 |
| 没有真实需求 + 没有独创证据 | 无效内容:既没有搜索和提问需求,也没有新增信息价值 | 直接砍掉,如果线上已有这类旧薄页,按内容审计流程合并或下线 |
用一张事实表,管住几十个页面和站外渠道的一致性
当一个主题集群做大以后,同一个产品参数或测试结论会同时出现在产品页、集合页、博客指南、对比页、YouTube 视频脚本、媒体通稿和销售话术里。
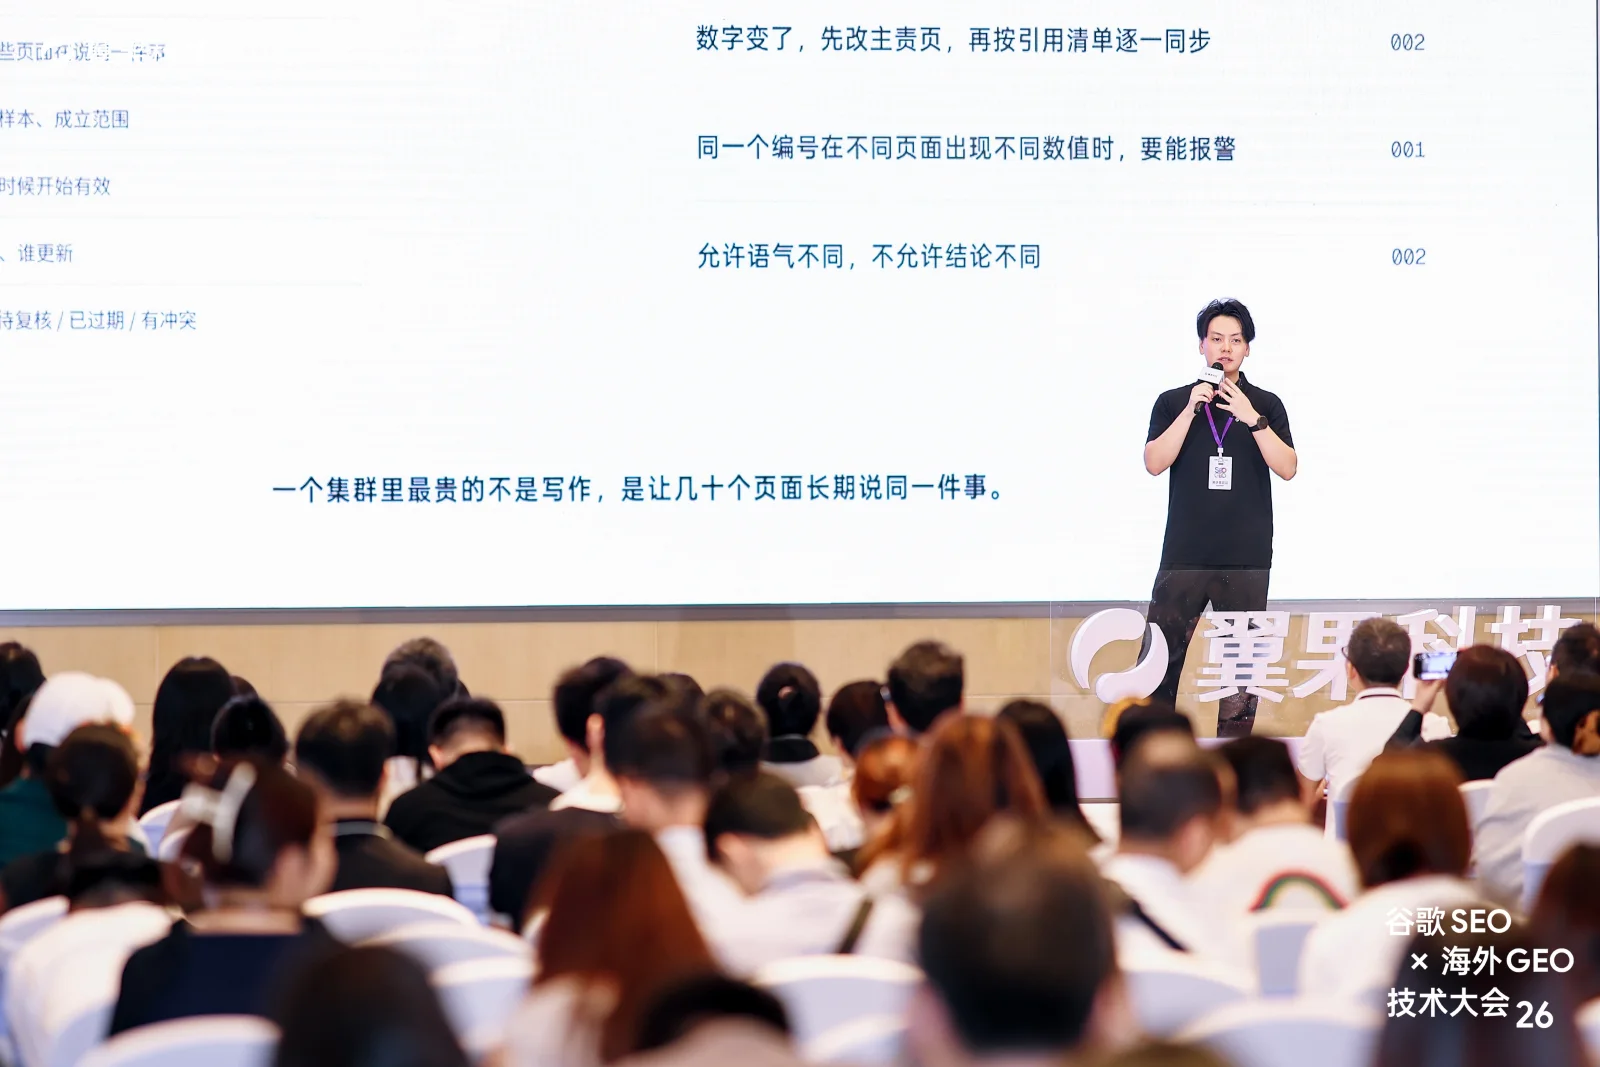
图:我在现场讲第 14 页课件:一个集群里最贵的不是写作,是让几十个页面长期说同一件事。
就像我在这页幻灯片底部写的那句话:一个集群里最贵的不是写作,是让几十个页面长期说同一件事。
很多独立站怎么在 AI 搜索里翻车的?产品升级换代了,或者促销改价了,运营只改了商品详情页,忘了改半年前发的那五篇对比博客和集合页底部的手写 FAQ(我在 261011 期周报的思考里也专门写过价格与库存写死在静态正文里导致 Merchant Center 拒登的坑)。结果 AI 爬虫和 Google 抓取时,发现你的产品页说续航 12 小时,博客说 10 小时,外部媒体稿写着 15 小时。当信源之间互相打架时,模型要么不敢引用你,要么直接拿过期的错误数字去回答用户。
为了解决这个问题,我们在内部推行了一张八字段事实维护表,配合四条硬性操作规则:
| 字段名称 | 具体记录什么 |
|---|---|
| 1. 主张编号(Claim ID) | 全站唯一的编号(如 CLM-014),方便跨页面追踪同一条结论 |
| 2. 结论原文 | 一句带着成立条件、可以被单独摘走而不产生歧义的完整判断 |
| 3. 主责页面 | 这个事实由哪一个具体的 URL 负总责(Canonical Source of Truth) |
| 4. 引用页面 | 记录站内还有哪些博客、对比页、集合页或站外渠道引用了这条事实 |
| 5. 依据与条件 | 支撑该结论的测试报告、样本量、测量工具和适用范围 |
| 6. 生效日期 | 这条事实从什么时候开始有效,以及设定的复测周期 |
| 7. 责任人(Owner) | 哪位产品经理、工程师或法务确认过这条事实,后续由谁负责更新 |
| 8. 状态 | 标明当前是“有效”“待复核”“已过期”还是“有冲突” |
建好表之后,日常维护严格按四条规则跑:
- 一个事实只有一个主责页面,其他所有页面都算引用它。
- 数字或结论变了,先改主责页,再按“引用页面”清单逐一同步修改。
- 同一个编号在不同页面出现不同数值时,必须能触发报警,立刻排查是漏改了,还是原本属于不同测试条件下的结果却漏写了条件。
- 允许语气不同,不允许结论不同。博客可以写得平实,社媒短视频可以抓场景痛点,销售话术可以更直接,但产品参数、价格与库存、适用人群、质保条件、核心卖点的边界,以及第三方引用数据的官网原始出处,这六件事绝对不能漂移。如果你想检查自己品牌在各平台的基础信息有没有打架,也可以先跑一遍站内的实体一致性检查工具。
过期的错误数据比没有数据更伤品牌,因为被引用出去的那句话是错的。所以每条证据除了写生效日期和责任人,还要明确五个必须触发复核的信号:产品型号或参数变更、价格库存或售后政策变更、测试到期需要重测、官方规则或行业标准变化、竞品发布新品或换了对比标准。每次复测时,不仅要看站内内容改没改,还要顺手记录两件事:AI 在这个问题上的回答变了没有?它引用的来源换了没有?
沿着 AI 的引用做信任源追溯,查清还缺哪块证据
前面讲了怎么管住自己手里的事实,那怎么知道在 AI 眼里,我们目前还缺哪块证据?我在课件第 17~19 页给出的办法是“信任源追溯(Citation Traceability)”。
很多团队看 GEO 报告只看一个“品牌提及率”,看到名字出现就觉得万事大吉。但被提及不等于被采信,采信的前提是有人能顺着链接查到过硬的证据。
做信任源追溯时,我们会把核心购买问题放进主流 AI 引擎,拿到回答后不做表面统计,而是把回答里的关键判断拆出来,连问七个问题追到底:
- AI 对这个问题给出了哪些明确判断?
- 每个判断后面具体引用了哪个网址?
- 这个来源属于品牌官网、行业媒体、独立评测、专家机构、社区论坛,还是零售平台?
- 点开那个网页,它里面的正文真的证明了这个判断吗?(例如 AI 引用某篇评测说某款沙发“更适合养宠家庭”,点进去却发现评测只聊了外观,根本没测耐刮和清洁。)
- 这个来源是否独立、是否已经过期(比如拿三年前的老款型号去论证今年的新款)、是否与其他来源矛盾?
- 哪些关键判断目前只有品牌自述,完全缺少第三方验证?
- 下一步我们需要补充什么材料,才能让这一判断获得更可靠的支持?
不同类型的主张,所需要的佐证材料完全不同。官网能解决“基础事实”,但一旦进入“好不好、值不值得买、和竞品比谁更合适”,单靠品牌自述通常是不够的:
| 关键主张类型 | 较合适的基础来源 | 需要补充的具体佐证 |
|---|---|---|
| 产品型号、尺寸、材质、功能 | 官网产品页、说明书、帮助中心 | 清晰的 HTML 参数表、Product 结构化数据、全网统一的型号命名 |
| 噪声、续航、耐用度等性能指标 | 官方技术资料、独立实验室或评测站 | 测试环境条件、实测原始数据、一镜到底的测试视频、第三方复测报告 |
| 舒适度、长期使用体验 | 用户真实评论、Reddit 等社区讨论、测评频道 | 具体使用场景描述、明确的优缺点、用过半年以上的长期反馈 |
| 是否适合某类特定人群 | 垂直行业媒体、领域专家、专业机构 | 清楚的适用边界(谁适合、谁别买)、专家解释与真实客户案例 |
| 与竞品相比是否值得购买 | 独立评测媒体、垂直榜单、用户横向讨论 | 同一条件下的对比表格、价格与配置差异、明确的选择依据 |
| 价格、库存、促销与退换货 | 官网商品页、零售商平台、Merchant Center 数据源 | 及时同步的价格、库存状态与明确的促销有效期 |
| 品牌身份、公司背景、行业奖项 | 官网关于页、行业数据库、奖项主办方页面 | 可交叉核验的公司实体信息、主办方原始获奖名单链接 |
我们把这套排查整理成了一张 11 个字段的《信任源追溯表》(包含关键词、核心提示词、关键主张、AI 当前回答、引用 URL、来源类型、证据状态、需要构建的佐证、内容载体、负责人及状态、复测结果)。
这张表真正的作用,是把 SEO、GEO、公关、社媒和广告团队连接到同一份事实上。广告投手提供高转化卖点和搜索词,社媒同学提供评论区反复吵的问题,客服与销售提供卡住成交的实际顾虑;SEO 团队把这些整理成核心提示词和关键主张,再顺着 AI 当前引用的网址反推还缺哪块证据。最终我们要回答的不是“下一篇博客写什么标题”,而是“全网还缺哪一块可以被核验、被引用的证据,这块证据该由内容、公关还是产品团队去补”。
一篇内容上线前,要过五道检查
把前面所有的要求收拢到日常发稿环节,就是课件第 20 页的那张“五道发布检查”图。
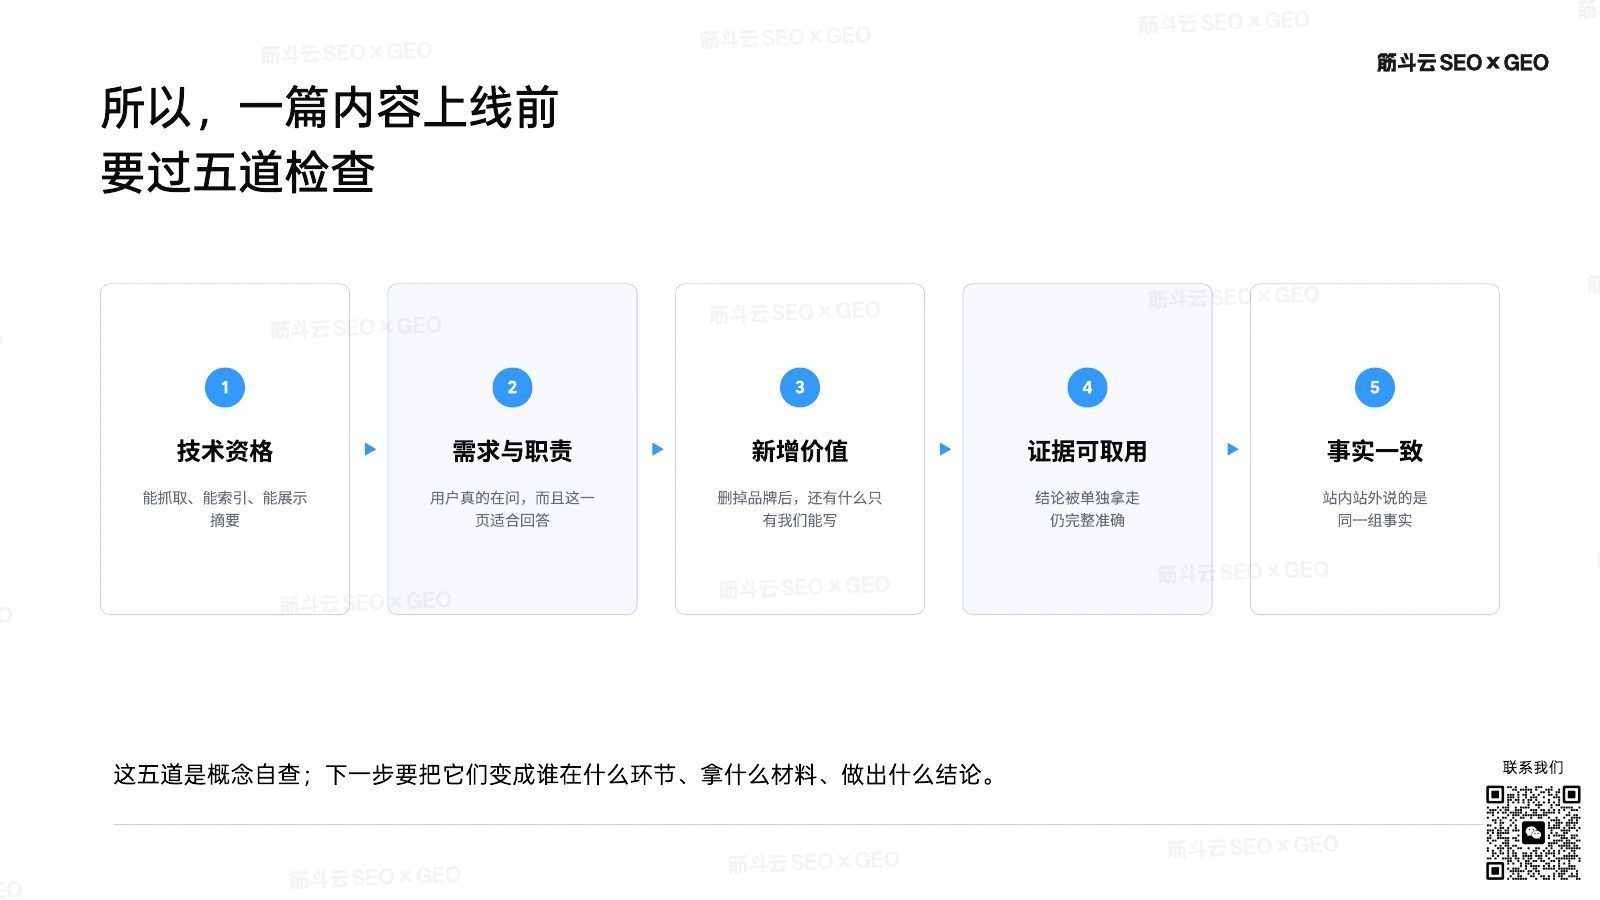
图:公开版课件第 20 页:一篇内容上线前要过的五道检查。
不管初稿是人写的还是 AI 辅助生成的,上线前编辑和审核人都要逐条过这五关:
- 技术资格:页面能不能被正常抓取、索引,并且有资格展示摘要?
- 需求与职责:这个问题是不是用户真的在问?由当前这个页面类型来回答合不合适?有没有和站内已有页面抢同一个词?
- 新增价值:做完“删除测试”、删掉品牌名之后,页面里还有什么信息是只有我们能写出来的?
- 证据可取用:核心结论和表格如果被 AI 或其他网站单独摘走,在脱离上下文的情况下是否仍然完整、准确、带着成立条件?(详见内容分块 Chunking 与可提取性)
- 事实一致:这一页里的数字、规格、边界,和站内其他页面、商品 Feed 以及站外渠道说的是不是同一组事实?
为什么我现在把发布门槛卡得这么严?因为 AI 把写字成本打下来之后,“再多生成几个 URL”已经毫无门槛,真正稀缺的是值得独立存在的页面。
我在分享现场讲了一个真实的失衡案例:某出海 DTC 品牌站上有上千篇博客,每篇格式都很工整,字数都在 1,500 字以上,看起来全都“合格”。但我们去翻他们客服和评论区用户天天在问的三个关键问题(这台设备能不能带上飞机、能不能带动我的医疗呼吸机、零下十度的冬天续航会掉多少),全站上千篇文章里,没有一篇正经拿实测数据和官方规则讲透。团队花了一整年优化文章产量,却把用户掏钱前真正要做的决定漏得干干净净。这种靠模板和 AI 批量铺近似页面的做法,也是 Google 2026 年 9 月垃圾更新 重点清洗的对象。
所以,决定要不要新建一个页面前,先回答三个问题:它解决了什么具体问题?相比站内已有页面新增了什么事实?用户为什么需要单独看这一页?答不上来,就去把现有的核心页补厚,不要再制造新的僵尸 URL。
从“交一篇文章”到“交一套主题包”:跨团队怎么共用一套证据
如果每次做内容都只停留在编辑部交一篇 Word 文档,前面讲的证据网和全网一致性根本执行不下去。因此,分享的后半部分我花了很多时间讲组织协作:把内容团队的交付物,从“一篇文章”升级为包含五件交付物的“主题包(Topic Pack)”。
围绕一个核心业务主题,一套完整的主题包至少包含这五样东西:
- 事实与主张表:品牌的事实底座。写清核心结论、产品参数、测试数据、来源文件、适用范围、不能外推的边界、负责人与审核人、有效期,以及明确禁止使用的夸大表达。
- 需求与页面地图:规定这份知识应该在哪里出现。列出对应关键词、Search Console 查询、用户决策阶段、页面类型、目标 URL、需要合并的旧页面、内链进出关系,以及最终承接转化的商业页面。
- 母版答案(写作蓝本):不是一句“请写一篇 2,000 字文章”,而是写明用户在解决什么问题、品牌的核心判断是什么、必写事实有哪些、必须承认的反例和限制是什么、必须出现的横向比较项,以及用户读完后能完成什么具体判断。
- 可复用证据模块:已经完成事实审核的“积木”。包括标准对比表、实测数字、工程师解释、前后对比图、客户场景案例、风险提示、计算公式或标准操作步骤。
- 渠道使用卡:把上面四件交付物,拆成每个团队真正需要拿到的具体产物,让各个岗位开箱即用。
拿前面那个“家庭影院座椅材料耐用性”做例子,当产品与工程团队先把材料规格、摩擦测试、清洁方法和质保边界确认好、填进事实表之后,十个岗位拿到的是同一套事实的不同切面:
| 团队 / 岗位 | 从主题包里拿到什么 | 具体产出的动作或材料 |
|---|---|---|
| 产品 / 工程 | 事实表、待确认问题清单、更新触发器 | 确认参数真伪、提供实验室测试条件与样品实拍 |
| SEO 团队 | 需求与页面地图、页面职责、URL 与内链方案 | 规划材料选择总览页、产品页规格表和两个材质对比页 |
| 内容编辑 | 母版答案(写作蓝本)、可复用证据模块、边界要求 | 写出包含成立条件与不适用场景的完整选购指南 |
| 视频团队 | 核心测试数字、视觉证据要求、清洁步骤 | 拍一段真实的污渍清洁过程与表面摩擦测试视频 |
| 社媒团队 | 场景切口与痛点结论 | 以“养宠家庭选沙发不要只看真皮标签”切入做帖子和短视频 |
| 销售团队 | 异议回答卡、竞品比较话术、适用人群表 | 直接用已核实的事实回答“有宠物 / 南方高温 / 高频使用”三类客户顾虑 |
| 客服 / 售后 | 使用条件、日常排查与维护步骤 | 把清洁禁忌和质保边界做成标准售后说明,减少因预期错误引发的退货 |
| PR / 媒体 | 数据故事、测试方法说明、官网原始出处链接 | 把不同材料的耐磨与透气测试整理成行业基准稿件对外发布 |
| 品牌 / 法务 | 允许表达清单、成立条件、禁止表达红线 | 审核绝对化用词与质保承诺,避免合规与客诉风险 |
| 开发 / 数据 | 商品 Feed 字段、结构化数据、Asset ID 与 Claim ID | 保证页面正文、Schema 与 Merchant Center 数据一致,回收各渠道表现并回流到事实表 |
这套流程最关键的一步是反向回流。销售在跟单时遇到了新竞品、客服发现某个参数老被买家误解、社媒评论区冒出了新的使用场景、或者产品团队更换了皮料供应商,这些一线信号全部要回流到问题地图和事实表里。这样下一轮做内容更新时,团队永远是在已有的材料上继续积累,而不是换个人又从零开始搜同行抄一遍。
页面不仅要给人看,还要让 AI 代理“敢动手”
在课件第 25 页,我专门留了一节讲 Agentic 时代的页面准备:过去我们只关心机器能不能读懂页面;现在 AI 代理(Agent)开始代表用户操作页面。
无论是 Google 正在推进的 AI Mode 商业体验与通用商业协议(UCP)、浏览器原生的 WebMCP 草案,还是 OpenAI 的 Computer-Using Agent 和 Shopify 的 Agentic Storefronts,机器正在替用户干五件事:比较产品、填写表单、添加购物车、提交订单、预约服务。
这时候,页面除了文字要清楚,还多出了一层“机器敢不敢继续执行”的问题。我们在做网站可用性和技术检查时,会重点核对以下细节:
- 按钮与操作名称是否明确:按钮写的是含糊的“提交(Submit)”,还是明确的“获取定制报价”“预约 15 分钟演示”?不要用没有任何语义和无障碍属性的
<div>加复杂悬浮态去假装按钮,这会让读取 DOM 和无障碍树(Accessibility Tree)的 Agent 卡死。 - 表单标签与后续预期是否清楚:表单字段能不能被机器准确读懂?提交之后由谁联系用户、通过邮件还是电话联系、多久回复、用户能不能修改或撤回?
- 状态反馈是否即时准确:某个尺码或配置选项当前是否已经选中?库存状态是现货还是预售?点击操作成功后页面状态有没有明确变化,失败后有没有清晰的错误提示?
- 跨通道数据是否严格一致:页面文案、Product Schema、产品 Feed 与 Merchant Center 里的库存、当前售价、划线价、订单状态以及退货与质保政策,是不是完全一致?
我在现场也明确画了界限:“Agent 友好”目前不是 Google 的搜索排名因子。 你不会因为把按钮改清楚了就自动排到第一名。但它直接决定当 AI 代理带着高意向买家来到你的独立站时,这单生意能不能顺利走完,还是因为数据冲突、按钮不可读而被机器直接放弃。
把需求、搜索、AI 回答和业务结果拆成四层观察
文章发出去、主题包跑起来之后,怎么评估效果?我在课件第 26~28 页给出的原则是:别把所有结果压成一个玄学“AI 可见度分数”,必须把需求、搜索可见性、AI 答案可见性和业务结果拆成四层看。
为什么不能只看某一个工具给的单一分数?因为 AI 搜索引擎的格局和回答本身都在剧烈波动。Similarweb 2025 年 6 月至 2026 年 5 月的网页访问数据显示,整个 AI 平台品类的月度网页访问量同比增长了 70%,达到 95 亿次,但内部份额一年就洗牌了一次(ChatGPT 从约 76% 变动到 53%,Gemini 从 8.6% 升至 27.5%,Claude、Perplexity 等也在变化);同时 ChatGPT 美国提问带引用的比例从 1.6% 升到了 6.8%。同一句问题,换一个引擎、换一个地区、换一个月份,甚至同一天连续问三次,给出的答案和引用列表都可能完全不同。
再看我们手头现有的官方工具:
- 已经有的:Google Search Console 在 2026 年 6 月上线了生成式 AI 性能报告,可以看 AI Overviews 与 AI Mode 的曝光,并按页面、国家、设备和日期分析;GA4 有了默认的
AI Assistants渠道,能识别来自 ChatGPT、Gemini、DeepSeek、Copilot、Perplexity、Grok 等带有 referrer 的访问(你也可以配合站内的 GA4 AI 流量追踪配置工具 和 AI 爬虫日志分析器 来核对爬虫抓取与实际引荐流量)。 - 还给不了的:没有任何第一方平台(无论是 Google 还是 OpenAI)会给你完整的用户 Prompt 清单;Google 自己的 AI Overviews 和 AI Mode 点击仍然混在常规的
Organic Search里;而且大量用户在 AI 里看完推荐后,是直接去搜品牌名或直接输入网址进站的,这部分无点击归因单靠默认 GA4 抓不到。
因此,我们在项目复盘时会按四层指标分开记录,并且建立自己的 AI 抽样规则:
| 观察层级 | 核心要回答的问题 | 具体核对的指标与动作 |
|---|---|---|
| 1. 需求层 | 用户是不是真的在问这个问题? | 关键词趋势、Search Console 新增查询、销售异议记录与客服工单数量 |
| 2. 搜索可见性 | 页面有没有进入候选并拿到位置? | 页面是否编入索引、自然曝光与点击、排名分布、哪个 URL 在承接、是否存在站内同词互抢 |
| 3. AI 答案可见性 | 品牌和事实有没有真正进入答案? | 区分三件事:品牌提及(有没有出现名字)、来源引用(列的是官网还是第三方)、事实吸收(答案有没有真正采用我们的数据且描述准确) |
| 4. 业务结果 | 这套内容有没有帮到生意? | 用户有没有进入产品页或服务页、品牌词搜索量有没有涨、有没有形成辅助转化、销售和客服有没有在用这套材料、有没有减少买错退货和重复咨询 |
在做第 3 层“AI 答案可见性”的人工或脚本抽样时,任何一份内部报告都必须同时写清八个抽样条件:引擎与模型版本、测试地区(查看不同地区的 Google 结果可配合 UULE 生成器)、语言、测试日期、是否清空历史会话、是否启用联网搜索、固定的问题清单、每道题的重复测试次数。
被提及不等于被引用,被引用不等于事实进入答案,事实进入答案也不等于自动带来生意。 单次提问截一张好看的图,只能用来记录某个瞬间的现象,既不能证明长期稳定的可见度,更不能直接证明是哪一项文案修改带来了变化。把条件固定下来,按月追踪同一个问题簇的分布变化,才能找到真正卡住的环节去修。
对你意味着什么
如果你负责一个独立站或出海品牌的内容与 SEO 团队,下周一回到公司不需要立刻推翻现有的所有排期,也不需要去追求“每月批量生成 200 篇 AI 文章”。你可以先挑一个客单价最高、用户买前顾虑最多的核心产品线,按下面五步先把一个主题跑通:
- 列一张真实的问题网络:拉上销售和客服坐半小时,把客户掏钱前最常问的 10 个具体问题(含使用场景、对比和售后顾虑)列出来,对照 Search Console 看看现有页面分别回答了哪几个,合并掉内容重复的薄页。
- 给核心稿件做一次删除测试:挑出目前流量最高或最重要的 3 篇指南/对比页,遮住品牌名,把里面谁都能写的行业套话砍掉,找产品经理或工程师补上真实测试条件、实测数字、不适用人群和质保边界。
- 建第一张全站事实表:哪怕先用飞书或 Google Sheets 建表,把这条产品线最重要的 20 条核心参数和结论编号立项,写清主责 URL、引用页面、生效日期和确认人,把散落在博客和 FAQ 里的过期价格和冲突参数改掉。
- 顺着 AI 引用做一次信源追溯:拿那 10 个核心问题去问一遍 Google AI Mode、ChatGPT 和 Perplexity,点开它们当前引用的每一个网址,看看哪些判断只有你们自说自话、哪些第三方旧评测还在用你们三年前的停产型号,列成下个月公关、评测和内容团队的补证据清单。
- 用五道检查和抽样规则管住进出:新内容上线前先过“技术资格、需求与职责、新增价值、证据可取用、事实一致”五道关;发布后用固定条件按月抽样记录提及、引用与事实吸收情况,把一线团队收到的问题反向回流到事实表里。
AI 确实把文字排成通顺句子的成本打到了接近零,但它没有降低搞清楚用户真问题、做出真实测试、为产品结论负责的成本。当我们不再把内容当成按篇结算的消耗品,而是当成一套可核查、可复用、跨团队共享的证据与主题包时,无论是 Google 排名还是 AI 引用,都会变成水到渠成的结果。
图:2026 年 8 月 12 日大会现场。
给老手:30 页公开版课件结构与引用研究明细
本文基于我在 2026 年 8 月 12 日翼果 SEO × GEO 技术大会现场分享的《一份内容,两处收割:既上 Google 排名,又被 AI 引用》30 页公开版课件展开撰写。各章节与课件页码对应关系如下:
| 本文章节 | 对应课件页码 | 课件核心内容与引用来源 |
|---|---|---|
| 为什么有排名,却不一定有 AI 引用 | 第 1—5 页 | 页面竞争(Page/URL)与事实选择(Claim/Fact/Evidence)对比;Seer Interactive《AIO Impact on Google CTR》2026 更新(53 个品牌、547 万条查询);Ahrefs 2025 年 7 月与 2026 年最新 AIO 引用页面自然排名分布对比;Google Search Central《AI features and your website》(2026-07-10 更新)五步原理 |
| 从关键词扩展到用户的问题网络 | 第 6—7 页 | Query fan-out 决策问题拆解(家庭影院座椅材料六项子问题网络);搜索需求、AI 提问需求与业务真实需求三源汇流及页面职责四问 |
| 内容矩阵、主题集群与证据网 | 第 8—11 页 | 内容矩阵、Hub & Spoke 与 Evidence Network 三层进阶;多行业 AI 引用域名分布研究(Reddit、LinkedIn、YouTube 引用占比及高等教育 74.7% 至 B2B 技术服务 0.0% 的官网引用差异);集群“引力中心”的五项条件 |
| 信息增益:用“删除测试”筛掉套话 | 第 12—13 页 | 信息增益删除测试;Danny Sullivan 2026 年 4 月及 7 月官方指南关于 Non-commodity content(独特、具体、真实经验)的表述;Aggarwal 等《GEO: Generative Engine Optimization》(IIT Delhi / Princeton, KDD 2024,GEO-bench 10,000 条查询及 Perplexity 复测数据);需求 × 证据四象限表 |
| 用一张事实表,管住几十个页面的一致性 | 第 14—16 页 | 长期维护的八个字段(Claim ID、结论原文、主责页面、引用页面、依据与条件、生效日期、责任人、状态)与四条操作规则;五个触发复核的信号;跨渠道六项一致性要求 |
| 沿着 AI 的引用做信任源追溯 | 第 17—19 页 | 信任源追溯七步提问;七类关键主张对应的基础来源与补充佐证表;《信任源追溯表》11 个字段与跨团队协作机制 |
| 一篇内容上线前,要过五道检查 | 第 20—21 页 | 上线前五道检查(技术资格、需求与职责、新增价值、证据可取用、事实一致);独立页面存在的三个问题与某 DTC 品牌上千篇博客漏掉三个核心购买问题的反例 |
| 从“交一篇文章”到“交一套主题包” | 第 22—24 页 | 主题包五件交付物(事实与主张表、需求与页面地图、母版答案、可复用证据模块、渠道使用卡);十个团队/岗位的具体分工与反向回流机制 |
| 页面不仅要给人看,还要让 AI 代理“敢动手” | 第 25 页 | AI Agent 交互检查项;参照 Google 2026 官方指南 agentic experiences、web.dev、OpenAI Computer-Using Agent、WCAG 状态规范与 Shopify Agentic Storefronts |
| 把需求、搜索、AI 回答和业务结果拆成四层观察 | 第 26—29 页 | 四层观察指标体系;Similarweb 2025.06–2026.05 AI 平台网页访问数据(不含 App);Search Console 生成式 AI 性能报告(2026 年 6 月上线)与 GA4 AI Assistants 渠道边界;AI 抽样八项必填条件 |
注:课件中引用的第三方行业统计与学术基准实验均受其各自样本范围、时间窗口(2025—2026 年)及统计方法限制,本文引用时已保留其原始前提,不将其作为 Google 内部排名算法的通用承诺。
关注微信公众号,继续交流 SEO 与 GEO
如果你关心技术 SEO、GEO、Shopify 和独立站内容建设,可以扫描下方二维码,关注我的微信公众号 “Linus SEO 海外流量玩家”,阅读后续的一线复盘与方法拆解。
你也可以从关于页、作品索引和免费 SEO / GEO 工具箱了解我和团队日常在做的事。如果你正在筹备内容团队内训或 SEO × GEO 主题交流,欢迎通过公众号直接联系我。
我在翼果 SEO × GEO 技术大会分享了什么:让内容既能排名,也能被引用