谷歌 SEO & AI 每周资讯和 Linus 思考 261004
2026 年 9 月 28 日至 10 月 4 日,AI 搜索开始从“回答问题”继续向持续监测、商品推荐和直接结账扩展。Google 的 9 月垃圾更新在 9 月 30 日出现第二轮波动,AI Mode 的信息监测功能向全球用户开放,符合条件的 Shopify 商家可以在 AI Mode 和 Gemini 中直接结账。与此同时,Google 发布 Gemini 4 Argon,OpenAI 在 DevDay 发布 Dots 和一批 Agent 工具,Anthropic 发布 Claude Sonnet 5.5。
这些变化都与 SEO 有直接关系:页面要成为可引用的来源,商品数据要能进入 AI 的购买流程,网站还要面对越来越多不经过页面访问的搜索和交易。个人站本周上线的工具属于站点维护,不列为本周重点。
本周要点
- Google 9 月垃圾更新在 9 月 30 日出现第二轮明显波动;截至周末,官方状态页仍显示更新进行中,完整周期可能持续两周。
- Marie Haynes 注意到 Google 对《创建有帮助、可靠、以人为本的内容》文档做了较大更新,新增对 Main Content、投入程度、原创性、准确性和误导性署名的明确说明。
- Google AI Mode 的信息监测功能向全球用户开放,用户可以让 AI Mode 持续跟踪网页、论坛、社交内容、实时数据和商品信息,并在条件变化时提醒。
- Google 将 AI Mode 和 Gemini 的原生结账扩大到符合条件的 Shopify 商家,商品发现、推荐和购买可以发生在站外对话界面内。
- Google 发布 Gemini 4 Argon,先向可信网络安全防御者开放,提供 100 万 token 输出上限,开发者和消费者版本仍在后续开放计划中。
- OpenAI DevDay 发布 Dots 这类长期运行的 Agent,以及面向开发者的 ChatGPT、Codex 和 API 更新;Anthropic 发布 Claude Sonnet 5.5,重点放在更快的 Agent 编码和更低的成本。
- 一项覆盖约 46 万条 AI 购物回答的研究显示,大型零售商在 ChatGPT 和 Google AI 的推荐中占据明显优势;在提示词中加入“independent”后,小型商家的推荐比例才明显上升。
Google 垃圾更新出现第二轮波动
Google 在 9 月 24 日启动的9 月垃圾内容更新原本就说明最长可能持续两周。9 月 28 日,Search Engine Roundtable 汇总了周末的排名波动;10 月 1 日又报道 9 月 30 日出现第二轮明显变化。站长反馈主要集中在程序化页面、模板化页面、Discover 和部分 AI 翻译内容,但这些都是行业观察,不是 Google 对更新目标的官方定义。
因此,本周不能把某一种页面形式直接判定为这次更新的目标。更稳妥的做法是把 9 月 25—27 日和 9 月 30 日之后的变化分成两个观察窗口,分别看页面、国家、查询、索引和流量来源。Google 状态页只确认更新适用于全球和所有语言,没有公开具体的垃圾手法或单页恢复规则。
如果某个目录在两个窗口都同步下降,再去检查页面是否主要由重复模板组成,是否缺少第一手信息,是否存在批量生成、误导性内容或过度的程序化扩展。先确定变化范围,再判断内容原因,才不会把一次更新中的正常波动误判成整站问题。
Marie Haynes:Google 把 Main Content 说得更具体
10 月 2 日,Marie Haynes 在这篇解读中记录了 Google 对创建有帮助、可靠、以人为本的内容文档的更新。Google 现在明确把 Main Content 定义为直接完成页面目的的部分,并列出投入程度、原创性、技能或经验、准确性等质量属性;文档还补充了对虚假作者身份的警告。Marie 的文章是行业解读,Google 文档本身才是规范来源。
这段变化对本周的垃圾更新尤其有用。检查页面时,应先问页面的主要任务是否在首屏和主体内容中被完成,再看导语、侧栏、CTA、模板和自动生成段落是否挤占了真正答案。Google 也说明,标签页和折叠区域可以承载内容,前提是用户能够访问;因此“内容放在折叠面板里”本身不是问题,关键是页面是否让用户顺利找到并使用主要内容。
Marie Haynes 在文章中进一步推测,模型能力提升可能会带来新的核心更新,这属于她的判断,不能当作 Google 的时间表。实际工作仍应以官方状态页和页面质量证据为准。
AI Mode 信息监测向全球用户开放
9 月 28 日,Google Search 产品副总裁 Robby Stein 宣布,AI Mode 的信息监测功能开始向全球所有用户开放。Search Engine Journal 和 Search Engine Land 的报道显示,用户可以让 AI Mode 监测一个持续变化的主题,例如商品补货、价格变化、赛事、天气或本地活动;系统会结合网页、论坛、社交内容、实时数据和 Shopping Graph,在条件变化时给出提醒。
这个功能改变了搜索的使用方式。用户不再只发起一次查询再点击结果,而是把一个主题交给搜索系统持续跟踪。对网站来说,长期更新的价格、库存、活动时间和产品规格,可能比一篇一次性解释文章更适合这种场景;但这不等于频繁修改日期就能获得更多曝光。页面必须真的提供变化中的事实,更新记录也要可核对。
对 GEO 监测而言,信息监测和普通 AI 引用是两种不同的结果。前者关注系统是否持续把某个网站当作可更新的来源,后者关注某次回答是否引用页面。后续报告不能只统计一次引用,还应该检查页面是否在不同时间仍然被系统找到、引用和正确描述。
AI Mode 和 Gemini 开始承接 Shopify 结账
9 月 22 日,Search Engine Land 报道 Google 已向符合条件的 Shopify 商家开放 AI Mode 和 Gemini 中的原生结账。Shopify 的帮助文档说明,消费者可以在 Google 的 AI 对话中看到商品、填写配送和付款信息,然后直接完成订单;商家仍可关闭直接结账,只保留商品发现,并把用户转回自己的站点。
这让商品 SEO 的重点从“能不能被搜索到”扩展到“能不能被 AI 正确理解并完成购买”。商品名称、价格、变体、库存、配送、退货和法律披露都需要在站点、商品 feed、结构化数据和 Merchant Center 中保持一致。AI 可以引用一个商品页面,却因为缺少库存或配送信息而无法把它放进可购买的推荐里。
直接结账还会改变数据分析。这是一个需要验证的推测:如果用户在 AI 界面完成购买,站点可能收不到传统意义上的产品页访问和结账事件,GA4 里的路径就不一定代表完整的购买过程。因此,Shopify 订单、Merchant Center、AI 渠道和站内分析需要放到一起核对,不能只看网站会话。
Gemini 4 Argon:更长的 Agent 工作流先进入受控环境
Google 在 9 月 30 日发布Gemini 4 Argon。官方称,Argon 先通过 Fairwind 计划向可信的网络安全防御者开放,之后再逐步扩展到开发者、企业和消费者。模型的输出上限扩大到 100 万 token,官方给出的介绍重点是复杂软件工程、法律和金融知识工作,以及网络安全防御。
Google 同时公布了几个内部使用案例,例如大规模代码迁移、内存优化和量子算法优化。这些案例是 Google 对内部工作的描述,不能直接当作所有企业部署后的效果。价格方面,Argon 的介绍页给出了每百万输入 token 2 美元、输出 10 美元的初始价格,但开发者和消费者的全面可用时间仍待后续通知。
对 SEO 和内容团队来说,真正有价值的信号不是 token 上限本身,而是 Agent 可以在更长上下文中同时处理站点资料、产品数据、日志和代码。这样的模型适合做跨文件审计和研究汇总,但越长的工作流越需要中间产物、权限边界和可追溯的引用,否则错误会在长链路里被放大。
OpenAI Dots 与 Claude Sonnet 5.5:Agent 产品继续向长期运行发展
OpenAI 在 9 月 29 日的DevDay 2026发布了多项产品更新,其中 Dots是一种可以长期运行的 Agent。官方介绍显示,Dots 拥有自己的云端计算机和浏览器,可以使用连接的应用,跨 ChatGPT、Slack 和 Teams 工作,并在用户批准后处理发票、研究、项目跟进等持续任务。该产品先向符合条件的 Pro、Business Premium 和 Enterprise 用户开放。
这个方向与一次性内容生成工具不同。Agent 会保留上下文、等待条件变化,再继续执行任务。对于 SEO 工作,它可以持续监测页面状态、抓取错误、价格和竞品变化,但这也要求把“发现问题”和“修改线上内容”分成不同权限,避免监控 Agent 自动把未经审核的结论发布出去。
Anthropic 在 9 月 28 日发布Claude Sonnet 5.5,官方称它比 Sonnet 5 快 30%,多数任务成本最高降低 30%,并在较低成本下提升代码和长任务表现。Anthropic 的测试结果属于厂商自己的评估,不能当作跨模型的独立排名;可以确认的是,主流模型厂商正在把重点从“能不能生成”转向“能否持续调用工具、完成任务并控制成本”。
AI 购物回答为什么偏向大型零售商
9 月 30 日,Search Engine Land 报道 Vaer AI 受 Lightspeed Commerce 委托进行的一项研究。研究使用约 20,000 个购物问题,生成接近 46 万条 ChatGPT、Google AI Mode 和 AI Overview 回答。没有实时搜索时,大型全国性零售商获得了约三分之二的推荐;开启实时搜索后,大型零售商仍占据 46% 至 58% 的首选推荐。
研究还发现,给模型相同商品、不给出商家规模提示时,大型零售商被选中的比例达到 90% 至 94%。把“independent”加入问题后,小型商家的推荐明显增加;“local”和“near me”带来的变化小得多。这个结果来自特定研究设计,不能证明所有 AI 系统都固定偏爱大型商家,但它揭示了一个实际问题:大型商家拥有更密集的商品 feed、评论、库存、配送、媒体报道和第三方页面,模型更容易确认它们。
独立站和小型零售商要补的内容,也因此不只是“增加一篇 GEO 文章”。网站需要用清楚的文字说明自己是谁、销售什么、服务哪些地区、为什么值得推荐;产品数据、Google Business Profile、评论、图片、库存和退货政策也要相互一致。研究中“independent”这个词有效,说明模型会根据明确的商业属性改变候选集合;但长期策略仍然是建立足够完整的公开证据,而不是等待用户替品牌补充关键词。
Google 与欧盟的搜索数据争议继续影响 AI 竞争
9 月 29—30 日,Reuters 报道 Google 正向欧盟法院申请暂停欧盟委员会关于开放搜索数据的要求。欧盟在 7 月要求 Google 向竞争对手,特别是 AI 聊天机器人和其他搜索引擎,提供部分搜索数据,以降低 Google 在搜索和 AI 搜索上的竞争优势;Google 则认为,未经充分匿名化的数据共享会带来隐私和安全问题。
这件事暂时不会改变站长今天如何写一篇页面,但它会影响 AI 搜索市场能否获得更多独立数据。未来如果更多 AI 系统能获得搜索索引、点击和排名数据,搜索入口之间的差距可能缩小;如果诉讼和技术限制继续存在,Google 的数据优势仍会影响 AI 产品的训练、检索和商业化。
Linus 思考
这一周最值得关注的是搜索产品的边界在往外扩。AI Mode 可以持续监测信息,Google 和 Shopify 把商品推荐直接连接到支付,Gemini 4 和 Dots 则把 Agent 的任务时间拉长。SEO 团队如果仍然只看关键词排名和网站会话,会越来越难解释用户究竟在哪里完成了发现、比较和购买。
与此同时,AI 搜索的推荐并不天然公平。大型零售商更容易进入模型的候选集合,是因为它们在商品数据、评论、库存和第三方来源上留下了更多可交叉验证的证据。独立站要争取的不是一个抽象的“AI 权重”,而是让品牌、产品和服务在具体问题下有足够清楚且一致的公开信息。
Agent 工具也不应该被当作发布按钮。它们适合持续检查、整理证据、发现变化和提出修改建议;最终的页面事实、商品承诺和商业动作仍然需要人负责。
对你意味着什么
- 把 9 月 25—27 日和 9 月 30 日之后分成两个 SEO 观察窗口,分别检查受影响页面、国家、查询、索引和转化。
- 为 AI Mode 和 Agent 场景维护可更新的事实:库存、价格、规格、配送、退货、服务范围和更新时间都要能被页面和 feed 共同验证。
- Shopify 商家要核对 AI 渠道是否已启用商品发现或直接结账,并用订单、Merchant Center、Shopify 和 GA4 对账,确认站外购买是否造成数据缺口。
- 对独立站做 AI 购物测试时,至少区分“被引用”“进入候选”“成为首选”“产生点击”和“完成购买”,不要用一个可见度分数代替完整漏斗。
- 使用长期运行的 Agent 时,把监测、建议、审批和发布分成不同权限;先在一个目录或一个市场试运行,再扩大范围。
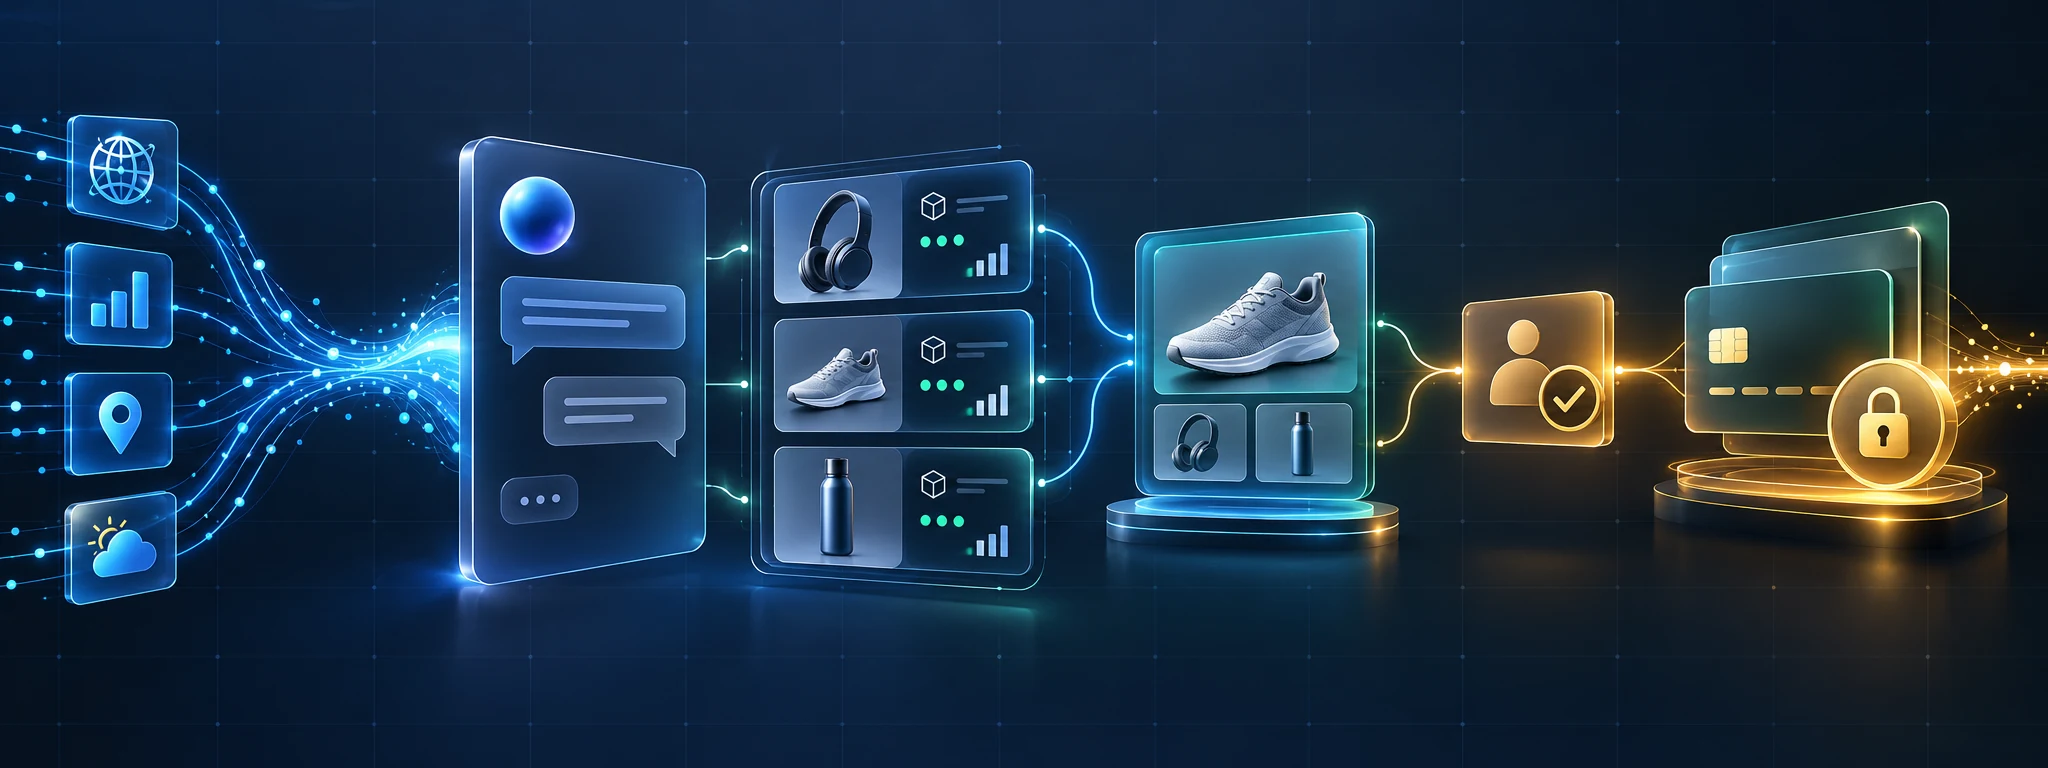
这周的重点不在于某个模型又多了一个版本,而在于搜索、推荐、监测和交易开始连接成一条连续链路。SEO 的工作对象正在从“搜索结果中的页面”扩展到“被 AI 找到、理解、推荐并完成后续动作的事实系统”。
谷歌 SEO & AI 每周资讯和 Linus 思考 261004
https://www.linusseo.com/google-seo-and-ai-newsletter-linus-thoughts-261004/