一文解析 Semrush 排名跟踪与 AI 搜索
每周一开会,老板问那几个核心词现在排第几。你在自己电脑上搜了一下,排第 5;同事在另一个城市搜,排第 9;Search Console 里写着平均排名 8.3;Semrush 里又是另一个数。这几个数字都没错,只是各自的算法和条件不一样。排名跟踪用固定的地区、设备和时间,每天记录同一批词的排名,让你能和上周、上个月比较。
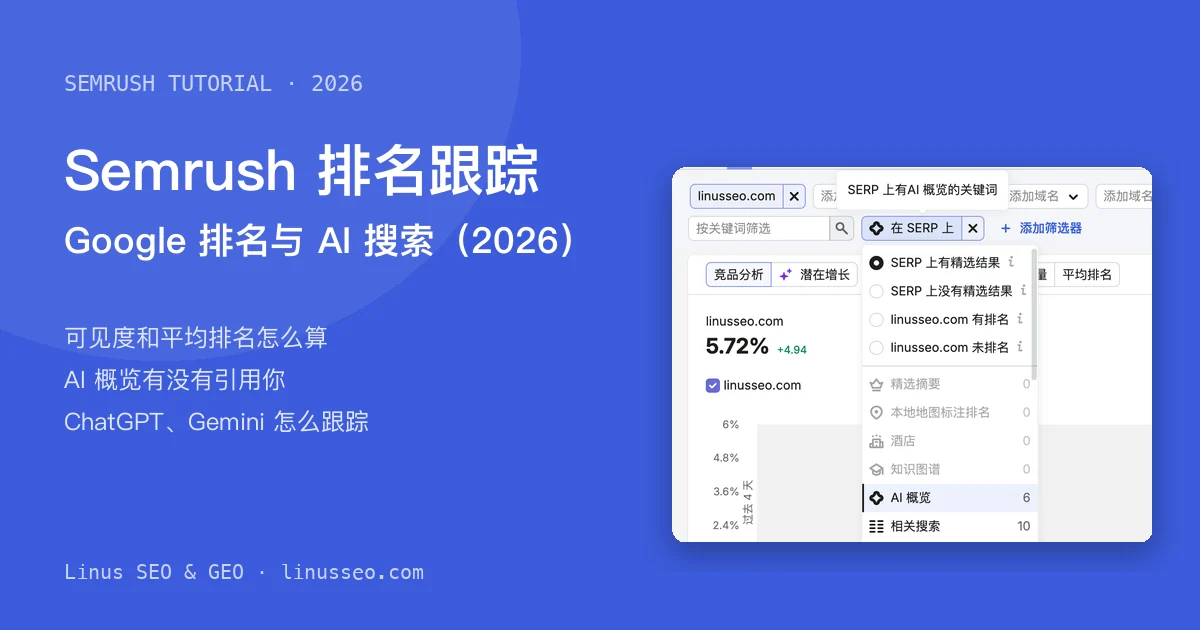
每周一开会,老板问那几个核心词现在排第几。你在自己电脑上搜了一下,排第 5;同事在另一个城市搜,排第 9;Search Console 里写着平均排名 8.3;Semrush 里又是另一个数。这几个数字都没错,只是各自的算法和条件不一样。排名跟踪用固定的地区、设备和时间,每天记录同一批词的排名,让你能和上周、上个月比较。
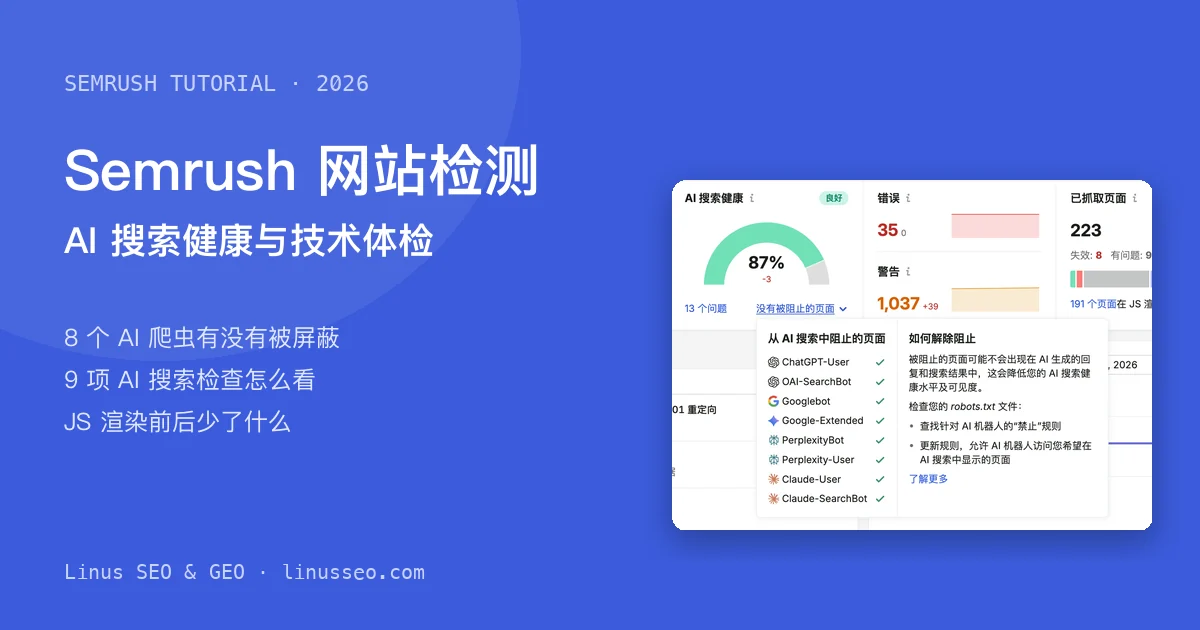
网站刚改版上线,或者刚接手一个独立站,你打开 Semrush 的网站检测(Site Audit)跑了一遍,结果是一个健康分数和几千条问题,红色的「错误」也有几十条。这时候最难的是判断先改哪条,因为有些「错误」改了也没有用。
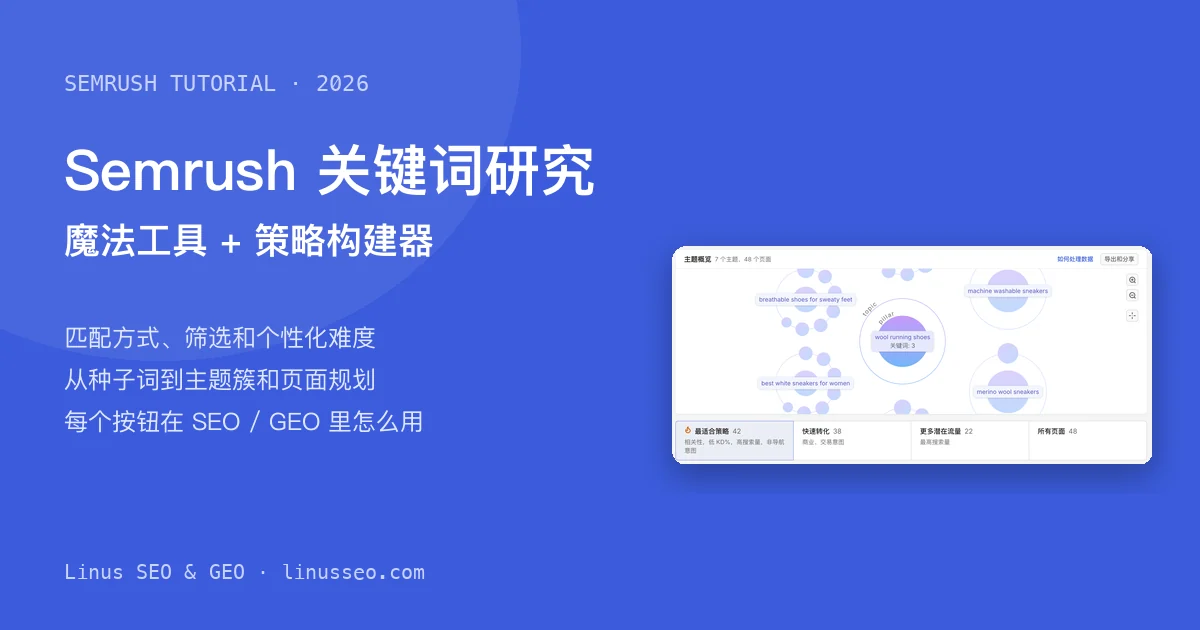
做独立站找词时,你可能经常遇到这种场景:准备切入一个新品类,或者想把现有品类的关键词重新理一遍,打开 Semrush 关键词魔法工具输入一个词,跳出来十几万条结果,不知道该挑哪批;好不容易挑了一堆词,又不知道该建几个页面来承接,最后只能堆在表格里。
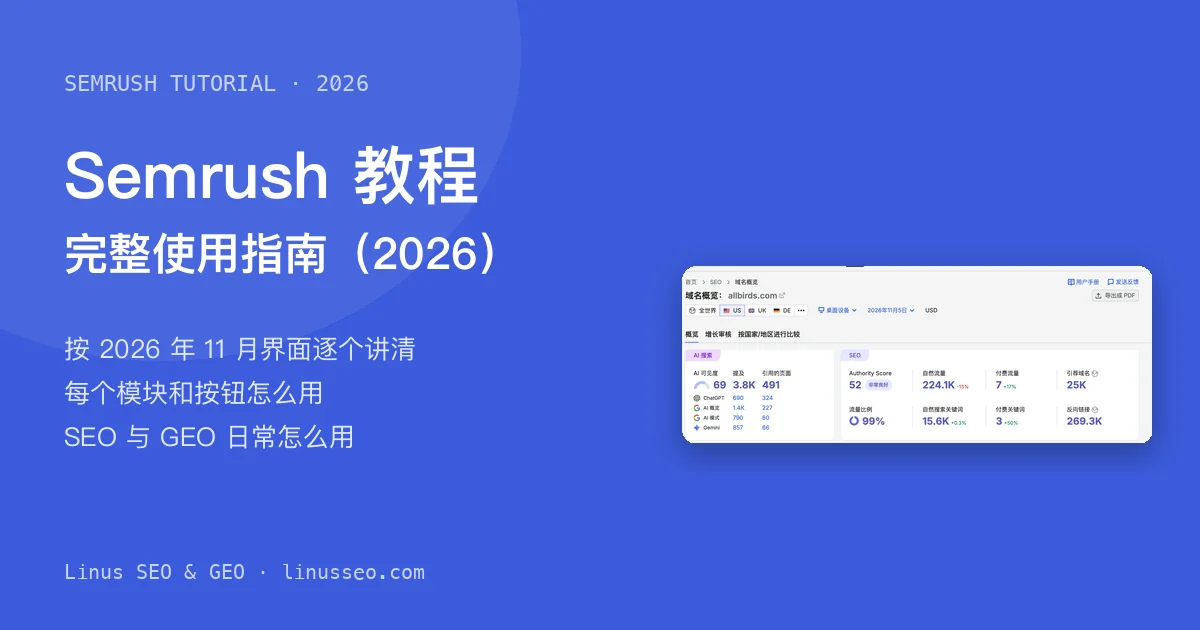
可能你经常遇到这种场景:老板突然丢来一个竞品网址让你摸清对方的底细,或者你想做新类目却不知道挑什么词,结果一打开 Semrush,左边密密麻麻几十个模块,完全不知道该先点哪一个。
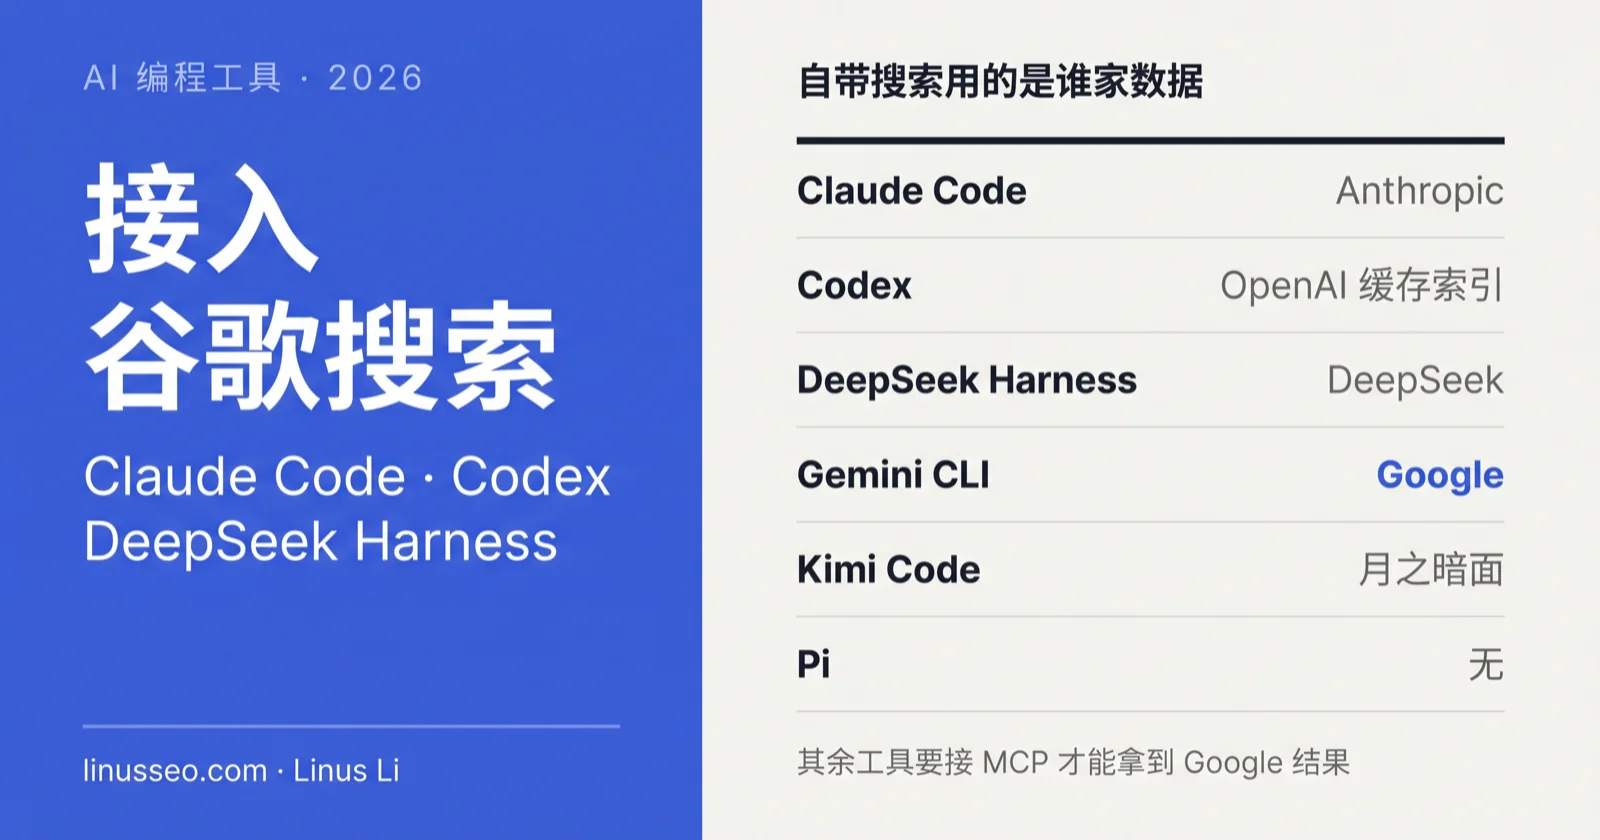
在 Claude Code 里让 AI“搜一下”,它确实会联网,但你拿到的通常不是 Google 的搜索结果。Codex、DeepSeek Harness、Kimi Code 也一样,它们各自用的是自家或合作方的搜索服务。
截至 2026 年 10 月 31 日,在常见的六个 AI 编程工具里,只有 Gemini CLI 自带的搜索用的是 Google 的数据。 其他工具想拿到 Google 的结果,要另外接 MCP 服务器或插件。最省事的做法是接 SerpApi 的官方 MCP,Claude Code 和 Codex 都只要一条命令。
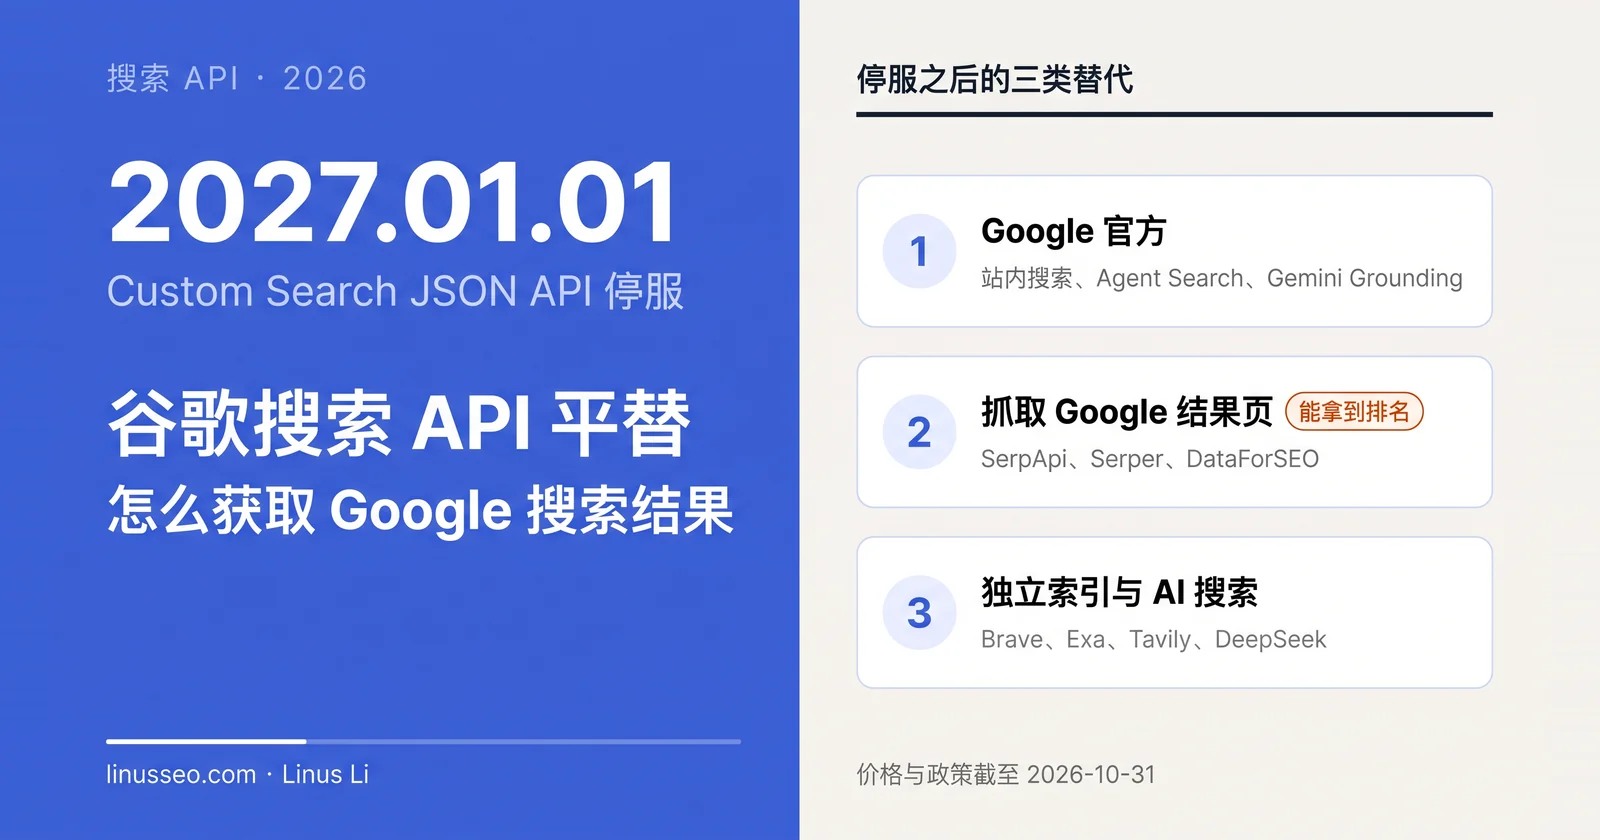
我在 NeverSec 时代写过一篇笔记,讲怎么用 Google 的 Custom Search JSON API 拿搜索结果。这个接口现在已经不接受新客户,并将在 2027 年 1 月 1 日停服。最近不少做 SEO 工具、数据抓取和 AI 应用的朋友在问同一个问题:停服以后,拿什么替代 Google 搜索?
截至 2026 年 10 月 31 日,Google 官方并没有一个能自助开通、直接返回全网搜索排名的 API。 很多团队直到旧接口停服才意识到:Custom Search JSON API 虽然叫 Custom Search,但当年被大量当成轻量级 SERP 接口使用。现在官方把路堵死,核心的分水岭只有一条:你到底是要 Google SERP 上的真实排名,还是只要模型能阅读的网页数据?
如果是前者(排名监控、SERP 特征追踪、竞品可见性分析),市面上任何官方 Grounding 接口都给不了,必须走抓取 Google 结果页的第三方通道;如果是后者(Agent 联网、知识库 RAG 检索),选用自建索引的搜索 API 往往更便宜、响应更快,也没有法务风险。
如果你只想尽快拿到搜索结果,直接看下一节的提示词。